
Cloud Storage là gì và lưu trữ dữ liệu bằng cách nào?
Mục lục
Cloud Storage cho phép lưu dữ liệu trên hạ tầng từ xa thay vì phụ thuộc vào ổ đĩa cục bộ. Hiểu cơ chế lưu, đồng bộ, truy cập và bảo vệ dữ liệu giúp phân biệt rõ dữ liệu thực sự nằm ở đâu, được truyền giữa các thiết bị ra sao và những lớp bảo vệ nào đang hoạt động.
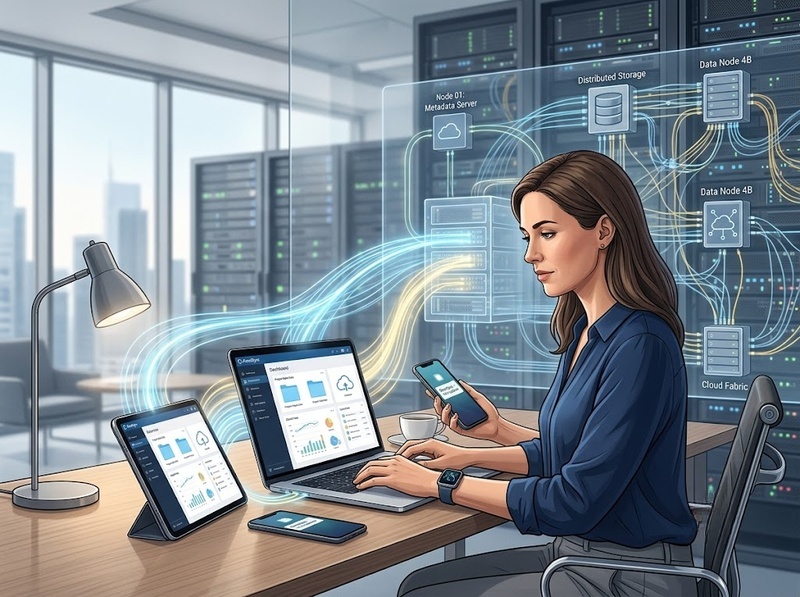
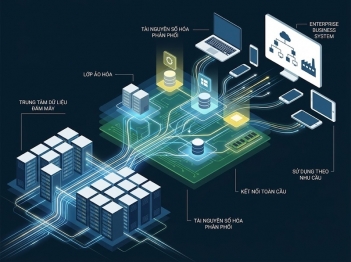
Cách hiểu chính xác về Cloud Storage không phải là hình dung một “ổ cứng trên Internet”. Người dùng nhìn thấy một không gian lưu trữ logic gồm thư mục, tệp hoặc đối tượng dữ liệu, nhưng phía sau đó có thể là một hệ thống phân tán gồm nhiều máy chủ, thiết bị lưu trữ, lớp metadata, dịch vụ xác thực và cơ chế dự phòng. Chính lớp trừu tượng này cho phép người dùng truy cập cùng một dữ liệu từ nhiều thiết bị mà không cần biết nó đang nằm trên ổ đĩa vật lý nào.
Cloud Storage là gì?
Cloud Storage, hay lưu trữ đám mây, là mô hình lưu dữ liệu trên hạ tầng máy tính từ xa và truy cập dữ liệu đó thông qua mạng. Thay vì ứng dụng phải biết chính xác ổ đĩa hoặc máy chủ vật lý chứa dữ liệu, nhà cung cấp dịch vụ tạo một lớp logic để người dùng thao tác với tệp, thư mục, object hoặc volume thông qua ứng dụng, giao diện web, giao thức mạng hoặc API.
Điểm quan trọng nằm ở sự tách biệt giữa vị trí logic và vị trí vật lý. Một tệp có thể được người dùng nhận diện bằng tên và đường dẫn cố định, trong khi các byte thực tế của tệp được phân bố, sao chép hoặc tái tổ chức trên nhiều thiết bị lưu trữ khác nhau. Hệ thống metadata chịu trách nhiệm duy trì mối liên hệ giữa đối tượng mà người dùng nhìn thấy và nơi dữ liệu thực sự được lưu.
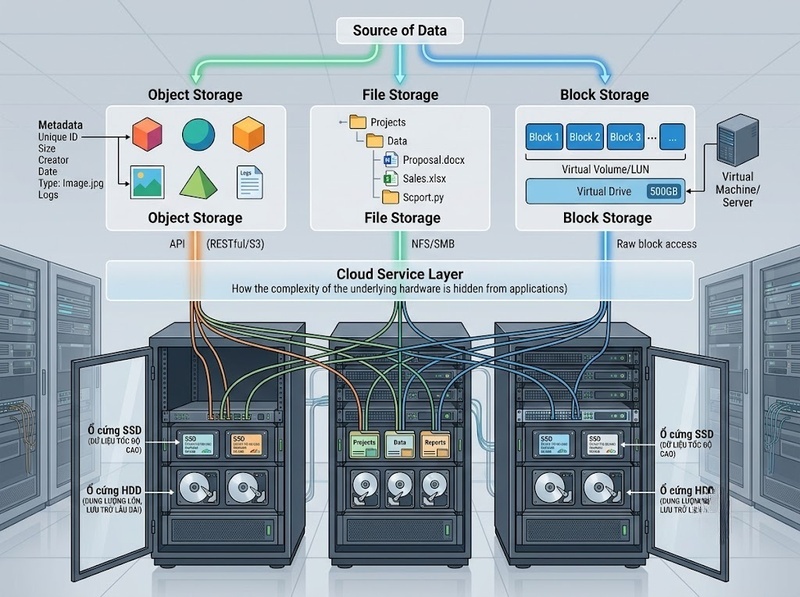
Cloud Storage cũng không chỉ có một cách tổ chức dữ liệu. Ba mô hình thường gặp là object storage, file storage và block storage. Object storage quản lý dữ liệu dưới dạng object đi kèm metadata và một định danh; file storage cung cấp cấu trúc thư mục–tệp quen thuộc; còn block storage cung cấp các khối lưu trữ để hệ điều hành hoặc máy ảo sử dụng như ổ đĩa. Cơ chế bên dưới khác nhau, nhưng đều có chung mục tiêu: tách ứng dụng khỏi việc phải quản lý trực tiếp phần cứng lưu trữ.
Vì vậy, “cloud” không có nghĩa dữ liệu tồn tại ở một nơi phi vật lý. Dữ liệu vẫn được ghi lên SSD, HDD hoặc các hệ thống lưu trữ chuyên dụng trong trung tâm dữ liệu. Điều thay đổi là người dùng làm việc với một dịch vụ lưu trữ logic thay vì trực tiếp vận hành các thiết bị đó.
Dữ liệu được lưu trên Cloud Storage như thế nào?
Khi một tệp được tải lên Cloud Storage, dữ liệu thường đi qua nhiều lớp trước khi được ghi xuống thiết bị lưu trữ. Đây là phần giải thích rõ nhất vì sao một thao tác tưởng như đơn giản là “Upload” lại có thể tạo ra khả năng truy cập từ nhiều thiết bị và tiếp tục hoạt động khi một phần hạ tầng gặp sự cố.
Từ yêu cầu tải lên đến vùng lưu trữ vật lý
Một quá trình ghi dữ liệu điển hình có thể được hình dung theo trình tự:
1. Ứng dụng hoặc trình duyệt gửi yêu cầu tải dữ liệu tới điểm cuối của dịch vụ
2. Hệ thống xác thực danh tính và kiểm tra người gửi có quyền ghi dữ liệu hay không
3. Dịch vụ tiếp nhận nội dung cùng metadata như tên, kích thước, loại dữ liệu, thời gian và định danh
4. Dữ liệu có thể được chia thành nhiều phần để truyền hoặc xử lý hiệu quả hơn
5. Các phần dữ liệu được ghi xuống hệ thống lưu trữ phân tán theo chính sách của dịch vụ
6. Hệ thống kiểm tra tính toàn vẹn và cập nhật metadata
7. Dịch vụ xác nhận thao tác ghi khi các điều kiện cần thiết của hệ thống đã được đáp ứng
Quá trình cụ thể không giống nhau ở mọi nền tảng. Một tệp nhỏ có thể được gửi trong một yêu cầu duy nhất, trong khi tệp lớn có thể sử dụng multipart upload hoặc cơ chế truyền theo từng phần. Tương tự, việc hệ thống chờ bao nhiêu bản sao được ghi thành công trước khi xác nhận cho ứng dụng phụ thuộc vào kiến trúc và mô hình nhất quán của từng dịch vụ.
Metadata, phân mảnh và dự phòng
Metadata là thành phần quan trọng vì hệ thống cần biết một đối tượng là gì và phải tìm dữ liệu của nó ở đâu. Metadata có thể bao gồm định danh, kích thước, phiên bản, quyền truy cập, checksum và thông tin phục vụ việc định tuyến tới các phần dữ liệu vật lý.
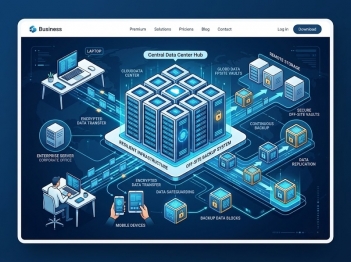
Để tránh việc hỏng một ổ đĩa đồng nghĩa với mất dữ liệu, hệ thống lưu trữ phân tán thường sử dụng replication hoặc erasure coding.
Với replication, nhiều bản sao của cùng dữ liệu được ghi vào các thiết bị hoặc vị trí khác nhau. Cách này đơn giản về mặt phục hồi nhưng tiêu tốn thêm dung lượng.
Erasure coding sử dụng cách tiếp cận khác. Với mô hình tổng quát k m, dữ liệu được chia thành k phần dữ liệu và tạo thêm m phần thông tin dự phòng. Khi một số phần bị mất, hệ thống có thể tái tạo dữ liệu nếu vẫn còn đủ số phần cần thiết. Cách tổ chức chính xác và khả năng chịu lỗi phụ thuộc vào thuật toán cũng như cấu hình mà nền tảng sử dụng.
Checksum hoặc các cơ chế kiểm tra tính toàn vẹn còn giúp hệ thống phát hiện dữ liệu bị thay đổi ngoài ý muốn trong quá trình truyền hay lưu trữ. Nếu phát hiện một bản sao không còn hợp lệ, hệ thống phân tán có thể sử dụng một bản hợp lệ khác để sửa chữa hoặc tái tạo dữ liệu.
Nhờ đó, người dùng nhìn thấy một tệp duy nhất, trong khi phía sau tệp đó có thể tồn tại nhiều thành phần dữ liệu, nhiều bản sao và nhiều lớp metadata phối hợp với nhau.
Cơ chế đồng bộ dữ liệu giữa nhiều thiết bị
Đồng bộ thường bị nhầm là chức năng mặc định của mọi hệ thống Cloud Storage. Thực tế, lưu trữ và đồng bộ là hai lớp có liên quan nhưng không hoàn toàn giống nhau. Backend lưu dữ liệu trên cloud, còn ứng dụng đồng bộ chịu trách nhiệm phát hiện thay đổi và làm cho nhiều bản dữ liệu tiến tới trạng thái phù hợp với nhau.
Phát hiện thay đổi và truyền phiên bản mới
Một ứng dụng đồng bộ trên máy tính có thể theo dõi thư mục cục bộ bằng cơ chế thông báo thay đổi của hệ điều hành hoặc một change journal. Khi người dùng sửa một tệp, client xác định rằng phiên bản cục bộ đã thay đổi và chuẩn bị cập nhật dữ liệu lên máy chủ.
Tùy thiết kế, client có thể tải lại toàn bộ tệp hoặc chỉ truyền những phần đã thay đổi. Kỹ thuật chỉ gửi phần khác biệt thường được gọi là delta synchronization, nhưng không phải dịch vụ nào cũng triển khai theo cùng một cách.
Khi server chấp nhận thay đổi, nó cập nhật phiên bản hoặc trạng thái của đối tượng. Các thiết bị còn lại sau đó biết có dữ liệu mới thông qua cơ chế thông báo từ server hoặc bằng cách định kỳ kiểm tra thay đổi. Client tải phiên bản cần thiết về và cập nhật bản cục bộ.
Quá trình có thể tóm gọn thành chuỗi:
Phát hiện thay đổi → Xác định phiên bản → Tải dữ liệu thay đổi lên → Cập nhật trạng thái trên cloud → Thông báo thiết bị khác → Tải phiên bản mới xuống
Vì một số bước diễn ra qua mạng, hai thiết bị không nhất thiết nhìn thấy sự thay đổi tại cùng một mili giây. Thời gian đồng bộ chịu ảnh hưởng bởi kết nối mạng, kích thước dữ liệu, trạng thái của client và cách dịch vụ phân phối thay đổi.
Xử lý xung đột đồng bộ
Vấn đề khó xuất hiện khi hai thiết bị cùng thay đổi một phiên bản cũ trước khi nhận được thay đổi của nhau.
Giả sử máy A và máy B cùng mở phiên bản 10 của một tệp. Máy A chỉnh sửa và tạo phiên bản 11. Trước khi máy B tải phiên bản 11 xuống, người dùng trên máy B cũng sửa phiên bản 10. Hệ thống lúc này phải quyết định cách xử lý hai nhánh thay đổi.
Một số ứng dụng giữ lại cả hai bản và tạo “conflicted copy”. Một số hệ thống có thể hợp nhất thay đổi nếu định dạng dữ liệu hỗ trợ cộng tác ở mức nội dung. Các hệ thống khác sử dụng quy tắc phiên bản hoặc yêu cầu ứng dụng tự giải quyết xung đột.
Do đó, “đồng bộ” không đồng nghĩa với việc tất cả thiết bị luôn có trạng thái giống nhau tức thời. Nó là một quá trình phát hiện, truyền và giải quyết các thay đổi theo mô hình nhất quán do dịch vụ quy định.
Cách người dùng và ứng dụng truy cập dữ liệu
Dữ liệu nằm trên cloud chỉ hữu ích khi hệ thống biết ai đang yêu cầu, người đó được phép làm gì và đối tượng nào cần được trả về.
Người dùng có thể truy cập Cloud Storage qua trình duyệt, ứng dụng đồng bộ, ứng dụng di động, giao thức chia sẻ tệp hoặc API. Dù giao diện khác nhau, backend thường phải thực hiện hai kiểm tra riêng biệt: authentication và authorization.
Authentication xác định danh tính của người hoặc ứng dụng đang gửi yêu cầu. Authorization xác định danh tính đó có quyền đọc, ghi, xóa hoặc chia sẻ tài nguyên cụ thể hay không. Đây là lý do đăng nhập thành công chưa có nghĩa người dùng được phép truy cập mọi dữ liệu trong hệ thống.
Các nền tảng có thể triển khai quyền thông qua IAM, role, policy, access control list hoặc những mô hình tương đương. Với ứng dụng, quyền truy cập thường được truyền bằng token hoặc credential thay vì gửi trực tiếp mật khẩu của người dùng trong từng yêu cầu.
Sau khi yêu cầu được cho phép, metadata giúp dịch vụ xác định đối tượng cần lấy. Hệ thống lưu trữ bên dưới đọc các phần dữ liệu cần thiết, kiểm tra tính toàn vẹn, tái cấu trúc nội dung khi cần rồi gửi kết quả về client.
Cache có thể được sử dụng để giảm số lần phải đọc lại dữ liệu từ lớp lưu trữ phía sau. Một ứng dụng đồng bộ cũng có thể giữ bản sao cục bộ để người dùng mở một số tệp khi không có kết nối mạng. Trong trường hợp đó, cloud vẫn là nơi duy trì trạng thái từ xa, nhưng bản cục bộ đóng vai trò bộ đệm hoặc bản làm việc cho đến khi kết nối được khôi phục.
Vì vậy, Cloud Storage không nhất thiết yêu cầu mỗi byte dữ liệu phải được tải lại từ trung tâm dữ liệu mỗi lần người dùng mở tệp. Cơ chế cache và đồng bộ có thể làm cho trải nghiệm trông giống như đang sử dụng một ổ đĩa cục bộ dù dữ liệu chính được quản lý từ xa.
Các lớp bảo vệ dữ liệu trong Cloud Storage
Không có một cơ chế duy nhất khiến Cloud Storage trở nên an toàn. Việc bảo vệ dữ liệu thường dựa trên nhiều lớp giải quyết các rủi ro khác nhau: nghe lén khi truyền, truy cập trái phép, hỏng thiết bị, hỏng dữ liệu hoặc xóa nhầm.
Mã hóa khi truyền và khi lưu
Khi dữ liệu di chuyển giữa client và dịch vụ qua HTTPS, TLS có thể bảo vệ nội dung khỏi việc bị đọc hoặc sửa trái phép trên đường truyền. TLS 1.3 được IETF chuẩn hóa trong RFC 8446; các môi trường hiện đại thường sử dụng TLS 1.2 hoặc TLS 1.3 tùy khả năng tương thích và cấu hình.
Sau khi dữ liệu tới hệ thống lưu trữ, nền tảng có thể tiếp tục mã hóa dữ liệu at rest. AES với khóa 256 bit là một lựa chọn phổ biến trong các hệ thống lưu trữ thương mại, nhưng không phải mọi Cloud Storage đều bắt buộc sử dụng cùng thuật toán hoặc cùng mô hình quản lý khóa.
Điểm cần phân biệt là mã hóa dữ liệu và quản lý khóa mã hóa. Nếu khóa được nhà cung cấp quản lý, mô hình kiểm soát khác với trường hợp khách hàng tự quản lý customer-managed key. Mã hóa mạnh cũng không thể bù đắp cho việc một tài khoản hợp lệ bị đánh cắp và kẻ tấn công được cấp đúng quyền giải mã hoặc tải dữ liệu.
Dự phòng, kiểm tra toàn vẹn và phiên bản
Mã hóa bảo vệ tính bí mật nhưng không giải quyết việc ổ đĩa bị hỏng. Vì thế Cloud Storage còn cần lớp bảo vệ về độ bền dữ liệu.
Replication và erasure coding giúp hệ thống tiếp tục tái tạo dữ liệu khi một số thành phần phần cứng thất bại. Checksum giúp phát hiện dữ liệu không còn khớp với trạng thái đã ghi nhận. Các tiến trình kiểm tra nền có thể phát hiện bản sao lỗi và sử dụng dữ liệu còn tốt để sửa chữa.
Versioning và cơ chế giữ lại dữ liệu đã xóa có thể tạo thêm một lớp phục hồi trước các thay đổi ngoài ý muốn. Tuy nhiên, các tính năng này phải thực sự được hỗ trợ và cấu hình phù hợp; không thể mặc định rằng bất kỳ Cloud Storage nào cũng lưu vô hạn mọi phiên bản cũ.
Cũng cần phân biệt durability và availability. Durability nói về khả năng dữ liệu vẫn còn nguyên vẹn theo thời gian. Availability nói về khả năng người dùng truy cập dịch vụ tại thời điểm cần thiết. Một hệ thống có thể bảo toàn dữ liệu rất tốt nhưng vẫn tạm thời không truy cập được do sự cố mạng hoặc dịch vụ.
Quyền truy cập vẫn là lớp bảo vệ bắt buộc
Một hệ thống có mã hóa và dự phòng tốt vẫn có thể làm lộ dữ liệu nếu quyền truy cập được cấu hình sai. Vì thế danh tính, quyền hạn, credential và nhật ký truy cập là một phần của cơ chế bảo vệ chứ không phải chức năng phụ.
Nguyên tắc thường được áp dụng là chỉ cấp cho tài khoản hoặc ứng dụng những quyền cần thiết cho nhiệm vụ của nó. Nếu một ứng dụng chỉ cần đọc một nhóm object, việc cấp cả quyền xóa toàn bộ vùng lưu trữ làm tăng hậu quả khi credential bị lộ.
Điều này phản ánh mô hình trách nhiệm chia sẻ của môi trường cloud: nhà cung cấp có trách nhiệm bảo vệ hạ tầng và các thành phần thuộc dịch vụ của họ, trong khi người sử dụng vẫn phải quản lý tài khoản, quyền truy cập, khóa, cấu hình chia sẻ và cách dữ liệu được sử dụng.
Giới hạn và những hiểu nhầm cần tránh
Hiểu cách Cloud Storage hoạt động cũng đòi hỏi hiểu những điều nó không tự động bảo đảm.
Trước hết, Cloud Storage và backup không phải cùng một khái niệm. Một thư mục đồng bộ có thể tạo bản sao trên cloud, nhưng nếu thao tác xóa được đồng bộ tới mọi thiết bị thì bản dữ liệu trên cloud cũng có thể biến mất. Nếu tài khoản bị chiếm quyền và kẻ tấn công mã hóa hoặc xóa dữ liệu bằng credential hợp lệ, quá trình đồng bộ thậm chí có thể truyền thay đổi có hại sang các thiết bị khác.
Versioning, immutable storage hoặc một bản backup độc lập có thể giảm rủi ro này, nhưng đó là các lớp bảo vệ bổ sung chứ không phải đặc tính mặc định của mọi dịch vụ Cloud Storage.
Thứ hai, dự phòng phần cứng không đồng nghĩa với dự phòng cho mọi thảm họa. Nhiều bản sao nằm trong cùng một phạm vi lỗi có thể bảo vệ khỏi hỏng ổ đĩa nhưng chưa chắc bảo vệ khỏi sự cố ảnh hưởng đến toàn bộ khu vực. Mức phân tán vật lý cần thiết phụ thuộc vào kiến trúc cụ thể của dịch vụ.
Thứ ba, mã hóa không ngăn được mọi hình thức mất dữ liệu. Encryption giải quyết chủ yếu bài toán bí mật của dữ liệu. Nó không tự ngăn người có quyền hợp lệ xóa tệp, ghi đè nội dung hoặc chia sẻ dữ liệu sai đối tượng.
Cuối cùng, hiệu quả của Cloud Storage vẫn phụ thuộc vào mạng. Cache và bản sao cục bộ có thể hỗ trợ làm việc tạm thời khi mất Internet, nhưng việc tải dữ liệu chưa có trên thiết bị, đồng bộ thay đổi hoặc truy cập trực tiếp vào backend cuối cùng vẫn cần kết nối tới dịch vụ.
Những giới hạn này không phủ nhận giá trị của Cloud Storage. Chúng cho thấy cloud storage là một hệ thống gồm nhiều lớp — lưu trữ phân tán, metadata, mạng, đồng bộ, xác thực, mã hóa và dự phòng — và mức bảo vệ cuối cùng phụ thuộc vào cách các lớp đó được thiết kế cũng như cấu hình.
Cloud Storage là một lớp lưu trữ logic được xây dựng trên hạ tầng vật lý phân tán. Khi dữ liệu được tải lên, dịch vụ xác thực yêu cầu, quản lý metadata, ghi dữ liệu vào hệ thống lưu trữ, tạo mức dự phòng cần thiết và cung cấp lại dữ liệu thông qua mạng. Ứng dụng đồng bộ theo dõi phiên bản để truyền thay đổi giữa các thiết bị; hệ thống truy cập kiểm soát danh tính và quyền; còn mã hóa, kiểm tra toàn vẹn, replication hoặc erasure coding giúp bảo vệ dữ liệu trước các nhóm rủi ro khác nhau. Hiểu các lớp này cũng giúp tránh hai nhầm lẫn quan trọng: dữ liệu trên cloud vẫn nằm trên phần cứng vật lý, và một bản dữ liệu được đồng bộ lên cloud chưa mặc nhiên là một bản backup độc lập.

GỬI Ý KIẾN BÌNH LUẬN
