
Data Lake là gì và phù hợp với trường hợp nào?
Mục lục
Data Lake là mô hình lưu trữ dữ liệu tập trung cho phép thu thập, lưu giữ và xử lý khối lượng dữ liệu lớn ở nhiều định dạng khác nhau. Hiểu rõ cách Data Lake hoạt động và thời điểm nên sử dụng giúp doanh nghiệp xây dựng nền tảng dữ liệu linh hoạt hơn
Data Lake là một kiến trúc lưu trữ dữ liệu cho phép tổ chức lưu giữ lượng lớn dữ liệu từ nhiều nguồn khác nhau ở dạng gần với dữ liệu gốc ban đầu. Khác với các hệ thống chỉ lưu trữ dữ liệu đã được làm sạch và cấu trúc trước, Data Lake có khả năng tiếp nhận cả dữ liệu có cấu trúc, bán cấu trúc và phi cấu trúc.
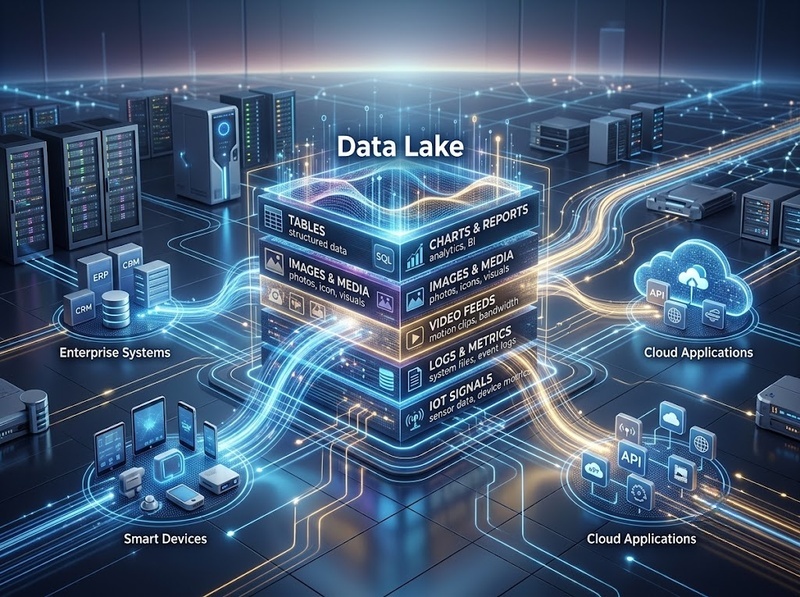
Mục tiêu chính của Data Lake là tạo ra một kho dữ liệu linh hoạt, nơi doanh nghiệp có thể lưu trữ dữ liệu trước khi phân tích, xử lý hoặc sử dụng cho các mục đích khác nhau như báo cáo, trí tuệ nhân tạo, học máy và ra quyết định.
Data Lake đặc biệt phù hợp với các tổ chức có nhu cầu khai thác dữ liệu lớn, dữ liệu phát sinh liên tục hoặc chưa xác định trước cách sử dụng trong tương lai.
Data Lake là gì?
Data Lake là mô hình kiến trúc dữ liệu được thiết kế để lưu trữ dữ liệu ở quy mô lớn mà không yêu cầu xác định cấu trúc dữ liệu hoàn chỉnh ngay từ đầu.
Trong Data Lake, dữ liệu thường được lưu giữ dưới dạng nguyên bản (raw data) từ nhiều nguồn như:
· Hệ thống giao dịch doanh nghiệp
· Ứng dụng di động
· Thiết bị IoT
· Nhật ký hệ thống
· Dữ liệu mạng xã hội
· Tệp văn bản, hình ảnh, âm thanh hoặc video
Điểm khác biệt quan trọng của Data Lake nằm ở cách tiếp cận "lưu trước, xử lý sau". Doanh nghiệp có thể thu thập dữ liệu trước và quyết định cách phân tích hoặc khai thác dữ liệu ở giai đoạn sau.
Điều này giúp Data Lake phù hợp với các môi trường mà:
· Nguồn dữ liệu thay đổi thường xuyên
· Khối lượng dữ liệu tăng nhanh
· Chưa biết trước toàn bộ nhu cầu phân tích
· Cần kết hợp nhiều loại dữ liệu khác nhau
Data Lake hoạt động như thế nào?
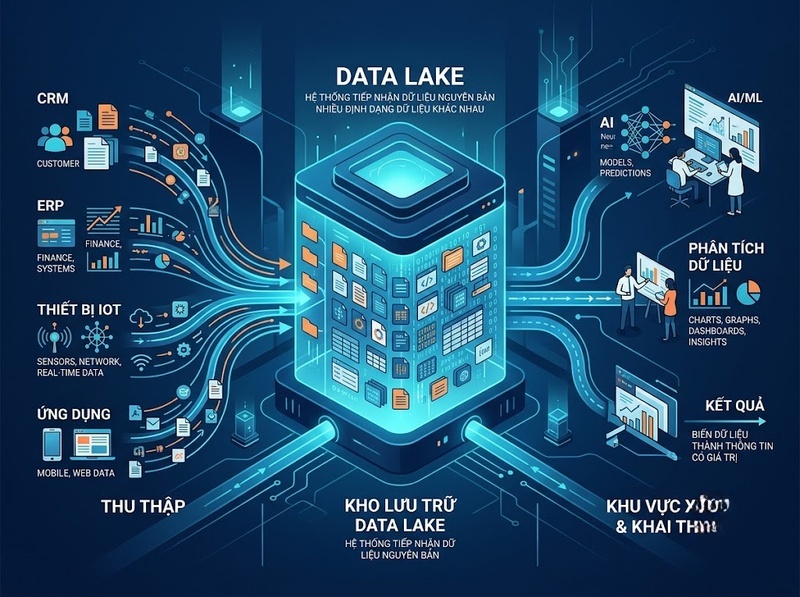
Data Lake thường vận hành theo chuỗi gồm thu thập dữ liệu, lưu trữ, xử lý và khai thác.
Thu thập dữ liệu từ nhiều nguồn
Data Lake tiếp nhận dữ liệu từ nhiều hệ thống khác nhau mà không cần chuyển đổi toàn bộ về một định dạng chung ngay lập tức.
Ví dụ:
· Dữ liệu khách hàng từ hệ thống CRM
· Dữ liệu giao dịch từ hệ thống ERP
· Dữ liệu hành vi từ website hoặc ứng dụng
· Dữ liệu cảm biến từ thiết bị IoT
Khả năng tiếp nhận đa dạng nguồn dữ liệu giúp doanh nghiệp xây dựng góc nhìn toàn diện hơn về hoạt động kinh doanh.
Lưu trữ dữ liệu ở dạng nguyên bản
Sau khi thu thập, dữ liệu được lưu trong Data Lake với định dạng phù hợp với từng loại dữ liệu.
Cách lưu trữ này giúp:
· Giảm thời gian chuẩn bị dữ liệu ban đầu
· Giữ lại đầy đủ thông tin gốc
· Cho phép xử lý dữ liệu theo nhiều mục đích khác nhau
Xử lý và phân tích dữ liệu khi cần
Khi có nhu cầu sử dụng, dữ liệu trong Data Lake có thể được xử lý bằng các công cụ phân tích dữ liệu, hệ thống học máy hoặc nền tảng trí tuệ nhân tạo.
Ví dụ:
Một doanh nghiệp thương mại điện tử có thể lưu dữ liệu truy cập website, lịch sử mua hàng và phản hồi khách hàng trong Data Lake. Sau đó, doanh nghiệp có thể sử dụng dữ liệu này để xây dựng mô hình dự đoán hành vi mua hàng.
Data Lake khác gì với Data Warehouse?
Data Lake và Data Warehouse đều là các mô hình lưu trữ dữ liệu nhưng khác nhau về cách tổ chức và mục đích sử dụng.
|
Tiêu chí |
Data Lake |
Data Warehouse |
|
Cấu trúc dữ liệu |
Lưu dữ liệu thô, nhiều định dạng |
Lưu dữ liệu đã được xử lý và cấu trúc |
|
Thời điểm xử lý |
Xử lý sau khi lưu trữ |
Xử lý trước khi lưu trữ |
|
Loại dữ liệu |
Dữ liệu có cấu trúc, bán cấu trúc, phi cấu trúc |
Chủ yếu dữ liệu có cấu trúc |
|
Tính linh hoạt |
Cao, phù hợp với nhu cầu thay đổi |
Thấp hơn nhưng tối ưu cho báo cáo ổn định |
|
Người sử dụng chính |
Data scientist, kỹ sư dữ liệu, nhóm phân tích nâng cao |
Nhóm kinh doanh, báo cáo quản trị |
Data Lake không thay thế hoàn toàn Data Warehouse. Hai mô hình có thể được sử dụng kết hợp để đáp ứng các nhu cầu dữ liệu khác nhau.
Data Warehouse phù hợp khi doanh nghiệp cần báo cáo định kỳ với dữ liệu đã được chuẩn hóa. Data Lake phù hợp khi doanh nghiệp cần khám phá dữ liệu, xây dựng mô hình phân tích nâng cao hoặc xử lý dữ liệu đa dạng.
Khi nào nên sử dụng Data Lake?
Data Lake phù hợp khi doanh nghiệp gặp các nhu cầu liên quan đến quy mô dữ liệu, tính đa dạng và khả năng khai thác dữ liệu trong tương lai.
Khi doanh nghiệp có lượng dữ liệu lớn và tăng nhanh
Các tổ chức tạo ra dữ liệu liên tục từ nhiều nguồn thường cần một nền tảng có khả năng mở rộng.
Ví dụ:
· Ngân hàng lưu trữ dữ liệu giao dịch lớn
· Công ty viễn thông xử lý dữ liệu người dùng
· Nền tảng thương mại điện tử thu thập dữ liệu hành vi khách hàng
Data Lake giúp lưu trữ lượng dữ liệu lớn mà không cần thiết kế toàn bộ cấu trúc ngay từ đầu.
Khi dữ liệu có nhiều định dạng khác nhau
Data Lake phù hợp với các trường hợp dữ liệu không chỉ tồn tại dưới dạng bảng dữ liệu truyền thống.
Ví dụ:
· Video từ camera giám sát
· Nội dung văn bản
· Dữ liệu cảm biến
· Nhật ký ứng dụng
Khả năng lưu trữ nhiều loại dữ liệu giúp doanh nghiệp có thêm nguồn thông tin để phân tích chuyên sâu.
Khi doanh nghiệp cần ứng dụng trí tuệ nhân tạo và học máy
Các mô hình AI và Machine Learning thường cần lượng lớn dữ liệu để huấn luyện và cải thiện độ chính xác.
Data Lake cung cấp môi trường để:
· Tập hợp dữ liệu huấn luyện
· Lưu giữ dữ liệu lịch sử
· Kết hợp nhiều nguồn dữ liệu
· Thử nghiệm các mô hình phân tích khác nhau
Khi nhu cầu phân tích dữ liệu chưa được xác định rõ
Trong nhiều trường hợp, doanh nghiệp chưa biết trước dữ liệu nào sẽ tạo ra giá trị trong tương lai.
Data Lake cho phép lưu giữ dữ liệu trước, sau đó khai thác khi xuất hiện nhu cầu mới.
Điều này đặc biệt hữu ích trong các lĩnh vực có tốc độ thay đổi cao như công nghệ, tài chính và thương mại điện tử.
Những giới hạn cần lưu ý khi triển khai Data Lake
Mặc dù Data Lake mang lại khả năng mở rộng lớn, việc triển khai không đúng cách có thể tạo ra các vấn đề về quản trị dữ liệu.
Data Lake có thể trở thành Data Swamp
Data Swamp là tình trạng Data Lake chứa quá nhiều dữ liệu nhưng thiếu quản lý, khiến dữ liệu khó tìm kiếm và khó sử dụng.
Nguyên nhân thường đến từ:
· Thiếu quy trình quản lý dữ liệu
· Không kiểm soát chất lượng dữ liệu
· Không có metadata đầy đủ
· Không phân quyền truy cập rõ ràng
Cần có chiến lược quản trị dữ liệu
Một Data Lake hiệu quả cần đi kèm với:
· Chính sách quản lý dữ liệu
· Cơ chế bảo mật
· Kiểm soát quyền truy cập
· Theo dõi nguồn gốc dữ liệu
· Quy trình đảm bảo chất lượng dữ liệu
Nếu chỉ tập trung vào việc lưu trữ mà bỏ qua quản trị, Data Lake có thể trở nên phức tạp và khó khai thác.
Không phải doanh nghiệp nào cũng cần Data Lake
Data Lake phù hợp nhất với tổ chức có:
· Khối lượng dữ liệu lớn
· Nhiều nguồn dữ liệu khác nhau
· Nhu cầu phân tích nâng cao
· Định hướng sử dụng AI hoặc Machine Learning
Với doanh nghiệp nhỏ chỉ cần báo cáo vận hành đơn giản, một hệ thống dữ liệu truyền thống có thể đáp ứng tốt hơn.
Data Lake mang lại lợi ích gì cho doanh nghiệp?
Khi được triển khai đúng cách, Data Lake giúp doanh nghiệp nâng cao khả năng khai thác dữ liệu thông qua:
· Tăng khả năng lưu trữ dữ liệu quy mô lớn
· Hỗ trợ nhiều loại dữ liệu khác nhau
· Tăng tốc độ thử nghiệm phân tích mới
· Tạo nền tảng cho AI và Machine Learning
· Giúp doanh nghiệp đưa ra quyết định dựa trên dữ liệu
Giá trị lớn nhất của Data Lake không chỉ nằm ở việc lưu trữ nhiều dữ liệu mà còn ở khả năng biến dữ liệu chưa được khai thác thành nguồn thông tin phục vụ chiến lược kinh doanh.
Data Lake là kiến trúc lưu trữ dữ liệu phù hợp với các tổ chức cần xử lý dữ liệu lớn, đa dạng và có nhu cầu khai thác dữ liệu linh hoạt trong tương lai. Mô hình này đặc biệt hữu ích khi doanh nghiệp muốn xây dựng nền tảng cho phân tích nâng cao, trí tuệ nhân tạo hoặc các ứng dụng dữ liệu mới.
Tuy nhiên, Data Lake chỉ phát huy hiệu quả khi đi kèm với chiến lược quản trị dữ liệu phù hợp. Việc lựa chọn triển khai Data Lake nên dựa trên quy mô dữ liệu, mục tiêu phân tích và khả năng vận hành của tổ chức.
Hỏi đáp về Data Lake
Data Lake có thay thế Data Warehouse không?
Không. Data Lake và Data Warehouse phục vụ các mục đích khác nhau. Data Lake phù hợp với dữ liệu lớn, đa dạng và nhu cầu phân tích linh hoạt, trong khi Data Warehouse phù hợp với báo cáo và phân tích dữ liệu đã được chuẩn hóa.
Doanh nghiệp nhỏ có nên sử dụng Data Lake không?
Doanh nghiệp nhỏ chỉ nên sử dụng Data Lake khi có nhu cầu xử lý dữ liệu lớn, nhiều nguồn dữ liệu hoặc phát triển các ứng dụng phân tích nâng cao. Nếu chỉ cần báo cáo cơ bản, các giải pháp đơn giản hơn có thể phù hợp hơn.
Data Lake có phù hợp cho AI không?
Có. Data Lake thường được sử dụng làm nền tảng dữ liệu cho các hệ thống AI và Machine Learning vì có khả năng lưu trữ lượng lớn dữ liệu đa dạng phục vụ quá trình huấn luyện và phân tích.

GỬI Ý KIẾN BÌNH LUẬN
