
Phân biệt Data Lake và Data Warehouse theo cách lưu trữ dữ liệu
Mục lục
- Data Lake và Data Warehouse là gì?
- Data Lake và Data Warehouse khác nhau như thế nào về cấu trúc lưu trữ?
- Schema-on-read và schema-on-write tạo ra khác biệt gì?
- Mục đích sử dụng của Data Lake và Data Warehouse khác nhau ra sao?
- Ai thường sử dụng Data Lake và Data Warehouse?
- So sánh Data Lake và Data Warehouse theo các tiêu chí chính
- Hiệu năng truy vấn khác nhau như thế nào?
- Chất lượng và quản trị dữ liệu khác nhau ra sao?
- Data Lake có rẻ hơn Data Warehouse không?
- Khi nào nên sử dụng Data Lake?
- Khi nào nên sử dụng Data Warehouse?
- Có cần chọn một trong hai hệ thống không?
- Những hiểu lầm thường gặp khi so sánh Data Lake và Data Warehouse
Data Lake lưu dữ liệu thô với cấu trúc linh hoạt, còn Data Warehouse tổ chức dữ liệu đã chuẩn hóa để phân tích ổn định. Bài viết làm rõ sự khác biệt về cách lưu trữ, quy trình xử lý, hiệu năng, quản trị và nhóm người dùng phù hợp.
Data Lake và Data Warehouse đều là hệ thống tập trung dữ liệu phục vụ phân tích, nhưng chúng giải quyết hai nhu cầu khác nhau. Data Lake ưu tiên khả năng tiếp nhận dữ liệu đa dạng với mức biến đổi tối thiểu, trong khi Data Warehouse ưu tiên dữ liệu đã được làm sạch, mô hình hóa và kiểm soát để tạo báo cáo nhất quán.
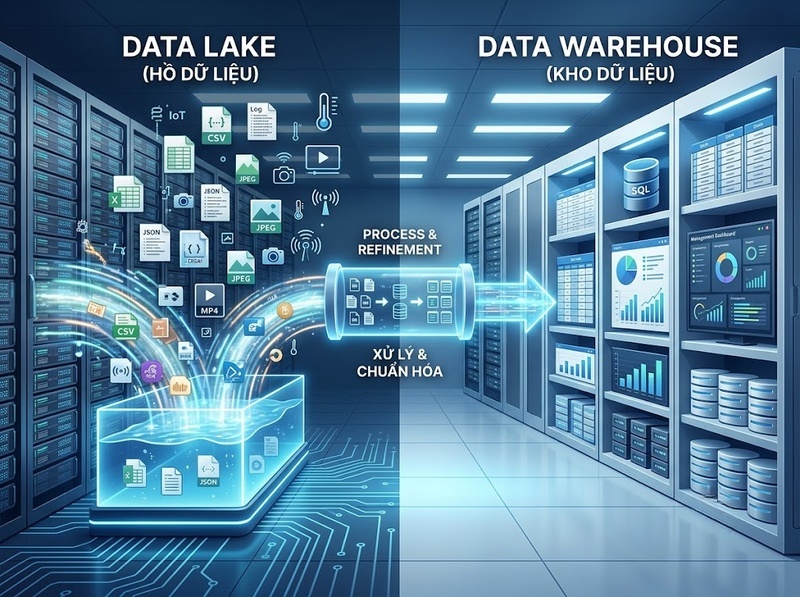
Khác biệt cốt lõi nằm ở thời điểm cấu trúc dữ liệu được xác định. Với Data Lake, cấu trúc thường được áp dụng khi dữ liệu được đọc và sử dụng. Với Data Warehouse, cấu trúc phải được thiết kế trước khi dữ liệu được nạp vào hệ thống. Sự khác biệt này ảnh hưởng trực tiếp đến mục đích sử dụng, tốc độ truy vấn, mức độ quản trị và đối tượng người dùng.
Data Lake và Data Warehouse là gì?
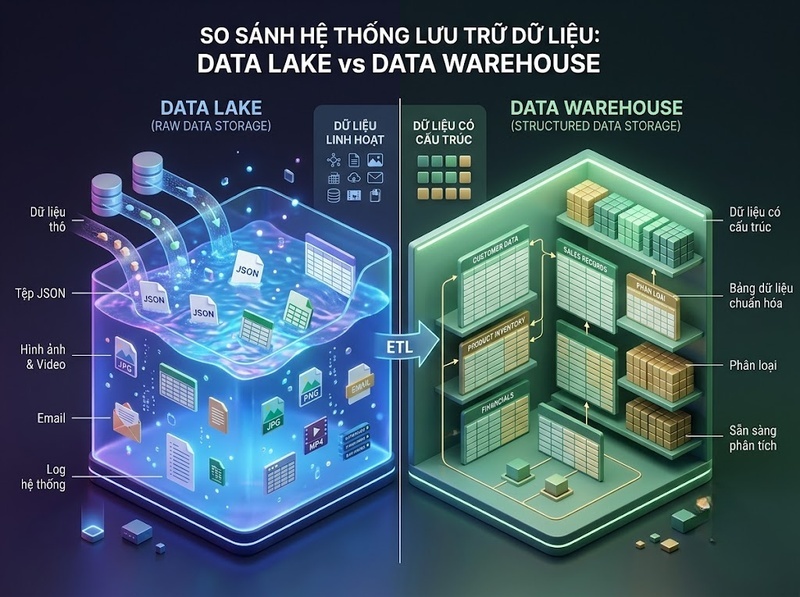
Data Lake là kho lưu trữ tập trung có khả năng tiếp nhận khối lượng lớn dữ liệu ở trạng thái gần với dữ liệu nguồn. Dữ liệu có thể là bảng giao dịch, tệp nhật ký, JSON, hình ảnh, âm thanh, dữ liệu cảm biến hoặc kết quả từ các ứng dụng nghiệp vụ.
Mục tiêu của Data Lake không phải biến mọi dữ liệu thành một mô hình hoàn chỉnh ngay khi tiếp nhận. Hệ thống chủ yếu bảo toàn dữ liệu để tổ chức có thể xử lý, khám phá hoặc tái sử dụng cho nhiều nhu cầu trong tương lai.
Data Warehouse là kho dữ liệu phân tích được xây dựng từ dữ liệu đã trải qua quá trình lựa chọn, làm sạch, chuyển đổi và mô hình hóa. Dữ liệu thường được tổ chức thành bảng, cột, khóa và quan hệ có định nghĩa rõ ràng.
Mục tiêu của Data Warehouse là cung cấp một nguồn dữ liệu đáng tin cậy cho báo cáo quản trị, phân tích kinh doanh và theo dõi chỉ số. Người dùng có thể đặt câu hỏi lặp lại trên cùng một mô hình dữ liệu và nhận kết quả ổn định.
Vì vậy, Data Lake thiên về lưu giữ dữ liệu linh hoạt, còn Data Warehouse thiên về cung cấp dữ liệu đã sẵn sàng để phân tích.
Data Lake và Data Warehouse khác nhau như thế nào về cấu trúc lưu trữ?
Data Lake lưu dữ liệu theo cấu trúc linh hoạt
Data Lake có thể lưu đồng thời ba nhóm dữ liệu:
· Dữ liệu có cấu trúc như bảng giao dịch, dữ liệu khách hàng và dữ liệu kế toán
· Dữ liệu bán cấu trúc như JSON, XML, log ứng dụng và sự kiện từ website
· Dữ liệu phi cấu trúc như hình ảnh, video, âm thanh và tài liệu văn bản
Dữ liệu thường được lưu dưới dạng tệp hoặc đối tượng trong một không gian lưu trữ phân tán. Cấu trúc thư mục, định dạng tệp, metadata và danh mục dữ liệu được sử dụng để xác định dữ liệu nằm ở đâu và có ý nghĩa gì.
Data Lake thường vận hành theo nguyên tắc schema-on-read. Hệ thống chưa bắt buộc phải áp đặt một mô hình quan hệ hoàn chỉnh tại thời điểm ghi dữ liệu. Cấu trúc phù hợp được xác định khi một công cụ hoặc người dùng đọc dữ liệu cho một mục đích cụ thể.
Cơ chế này tạo ra tính linh hoạt cao. Cùng một tập dữ liệu thô có thể được xử lý thành nhiều mô hình khác nhau cho phân tích hành vi, học máy, phát hiện bất thường hoặc kiểm thử giả thuyết.
Đổi lại, dữ liệu linh hoạt không đồng nghĩa với dữ liệu không cần quản trị. Nếu thiếu metadata, phân quyền, kiểm tra chất lượng và quy tắc đặt tên, Data Lake có thể trở thành nơi chứa nhiều dữ liệu nhưng khó tìm kiếm, khó hiểu và khó tin cậy.
Data Warehouse lưu dữ liệu theo mô hình xác định trước
Data Warehouse thường lưu dữ liệu có cấu trúc trong các bảng được thiết kế cho phân tích. Dữ liệu có thể được tổ chức theo mô hình hình sao, mô hình bông tuyết hoặc các lớp dữ liệu nghiệp vụ tương đương.
Một mô hình phổ biến gồm:
· Bảng sự kiện chứa số liệu có thể đo lường như doanh thu, số lượng bán hoặc lượt giao dịch
· Bảng chiều chứa ngữ cảnh phân tích như thời gian, khách hàng, sản phẩm và khu vực
· Khóa liên kết các bảng để người dùng phân tích số liệu theo nhiều chiều
Data Warehouse thường vận hành theo nguyên tắc schema-on-write. Trước khi dữ liệu được nạp, tổ chức phải xác định tên trường, kiểu dữ liệu, quan hệ, quy tắc chuyển đổi và ý nghĩa nghiệp vụ.
Cách tiếp cận này làm giảm tính linh hoạt trong giai đoạn tiếp nhận, nhưng tạo ra một môi trường phân tích ổn định. Khi các định nghĩa như “doanh thu thuần”, “khách hàng hoạt động” hoặc “đơn hàng hoàn tất” đã được chuẩn hóa, các phòng ban có thể sử dụng chung một cách tính.
Data Warehouse vì thế phù hợp với các truy vấn cần tính nhất quán, khả năng kiểm toán và hiệu suất dự đoán được.
Schema-on-read và schema-on-write tạo ra khác biệt gì?
Schema-on-read và schema-on-write không chỉ là hai kỹ thuật xử lý dữ liệu. Chúng phản ánh hai cách phân bổ công việc khác nhau trong vòng đời dữ liệu.
Với schema-on-read, dữ liệu được thu thập trước rồi mới diễn giải theo từng nhu cầu sử dụng. Phần lớn công việc mô hình hóa được chuyển sang thời điểm phân tích. Cách này có lợi khi tổ chức chưa biết trước toàn bộ câu hỏi sẽ đặt ra hoặc cần bảo toàn dữ liệu nguồn để thử nghiệm trong tương lai.
Với schema-on-write, dữ liệu phải vượt qua các bước kiểm tra và chuyển đổi trước khi đi vào kho phân tích. Công việc chuẩn hóa được thực hiện sớm hơn, giúp giảm độ phức tạp cho người dùng cuối.
Ví dụ, dữ liệu đơn hàng từ nhiều hệ thống có thể dùng các mã trạng thái khác nhau. Data Lake có thể giữ nguyên từng bản ghi và mã nguồn. Data Warehouse cần ánh xạ các mã đó thành một bộ trạng thái chung trước khi người dùng lập báo cáo.
Không có cơ chế nào luôn tốt hơn. Schema-on-read tối ưu cho khả năng khám phá và tái sử dụng dữ liệu; schema-on-write tối ưu cho tính nhất quán và khả năng sử dụng lặp lại.
Mục đích sử dụng của Data Lake và Data Warehouse khác nhau ra sao?
Data Lake phục vụ khám phá và xử lý dữ liệu đa dạng
Data Lake phù hợp khi tổ chức cần:
· Thu thập dữ liệu từ nhiều nguồn với tốc độ cao
· Giữ lại dữ liệu chi tiết hoặc dữ liệu lịch sử
· Xử lý nhật ký hệ thống và dữ liệu sự kiện
· Xây dựng mô hình học máy
· Khám phá dữ liệu chưa có mô hình nghiệp vụ cố định
· Tái xử lý dữ liệu khi logic phân tích thay đổi
Giá trị của Data Lake nằm ở khả năng giữ lại nhiều tín hiệu mà hệ thống phân tích truyền thống có thể loại bỏ. Một nhóm khoa học dữ liệu có thể quay lại dữ liệu nguồn, chọn biến mới và xây dựng lại tập huấn luyện mà không phụ thuộc hoàn toàn vào mô hình báo cáo đã thiết kế trước đó.
Tuy nhiên, dữ liệu trong Data Lake không mặc nhiên sẵn sàng cho mọi người dùng. Trước khi phân tích, người dùng có thể phải xác định định dạng, loại bỏ bản ghi lỗi, xử lý giá trị thiếu, liên kết nguồn và đánh giá độ tin cậy.
Data Warehouse phục vụ báo cáo và phân tích nghiệp vụ ổn định
Data Warehouse phù hợp khi tổ chức cần:
· Xây dựng báo cáo quản trị định kỳ
· Theo dõi KPI giữa các phòng ban
· Phân tích doanh thu, chi phí và hiệu quả vận hành
· Cung cấp dữ liệu cho công cụ Business Intelligence
· Đảm bảo các chỉ số sử dụng định nghĩa thống nhất
· Hỗ trợ kiểm toán và truy vết nguồn dữ liệu
Trong Data Warehouse, quá trình làm sạch và mô hình hóa đã được thực hiện trước. Người dùng nghiệp vụ không cần hiểu toàn bộ cấu trúc của từng hệ thống nguồn để trả lời các câu hỏi quen thuộc.
Chẳng hạn, ban điều hành muốn xem doanh thu theo tháng, khu vực và nhóm sản phẩm. Data Warehouse có thể cung cấp mô hình đã chuẩn hóa để truy vấn trực tiếp, thay vì yêu cầu người dùng ghép dữ liệu đơn hàng, thanh toán, hoàn tiền và danh mục sản phẩm mỗi lần lập báo cáo.
Ai thường sử dụng Data Lake và Data Warehouse?
Data Lake thường được sử dụng bởi các nhóm có khả năng xử lý dữ liệu ở mức kỹ thuật sâu hơn, bao gồm:
· Data Engineer
· Data Scientist
· Machine Learning Engineer
· Data Analyst có năng lực lập trình
· Nhóm nghiên cứu và phát triển sản phẩm dữ liệu
Những người dùng này thường cần truy cập dữ liệu chi tiết, viết mã xử lý, kiểm tra giả thuyết và tạo ra các tập dữ liệu mới.
Data Warehouse hướng đến nhóm người dùng cần dữ liệu đã được tổ chức rõ ràng, bao gồm:
· Business Analyst
· Chuyên viên tài chính
· Nhân sự marketing và bán hàng
· Quản lý vận hành
· Ban điều hành
· Người xây dựng dashboard và báo cáo BI
Ranh giới người dùng không hoàn toàn tuyệt đối. Data Engineer vẫn xây dựng đường ống dữ liệu cho Data Warehouse, còn Data Analyst vẫn có thể khai thác dữ liệu từ Data Lake. Điểm khác biệt nằm ở mức độ chuẩn bị dữ liệu mà hệ thống cung cấp trước khi người dùng bắt đầu phân tích.
So sánh Data Lake và Data Warehouse theo các tiêu chí chính
|
Tiêu chí |
Data Lake |
Data Warehouse |
|
Trạng thái dữ liệu |
Dữ liệu thô hoặc đã xử lý một phần |
Dữ liệu đã làm sạch và chuẩn hóa |
|
Loại dữ liệu |
Có cấu trúc, bán cấu trúc và phi cấu trúc |
Chủ yếu là dữ liệu có cấu trúc |
|
Cách áp dụng cấu trúc |
Thường là schema-on-read |
Thường là schema-on-write |
|
Mục tiêu chính |
Khám phá, xử lý dữ liệu lớn, học máy |
Báo cáo, BI, phân tích nghiệp vụ |
|
Mức linh hoạt |
Cao |
Thấp hơn do mô hình được xác định trước |
|
Tính nhất quán |
Phụ thuộc vào lớp xử lý và quản trị |
Cao hơn trong phạm vi mô hình đã chuẩn hóa |
|
Tốc độ tiếp nhận dữ liệu mới |
Nhanh vì ít biến đổi ban đầu |
Chậm hơn vì cần làm sạch và ánh xạ |
|
Hiệu suất truy vấn |
Phụ thuộc định dạng, tổ chức tệp và công cụ xử lý |
Thường được tối ưu cho truy vấn phân tích |
|
Người dùng chính |
Kỹ sư dữ liệu, nhà khoa học dữ liệu |
Nhà phân tích, quản lý, người dùng BI |
|
Quản trị |
Khó hơn khi dữ liệu quá đa dạng |
Dễ kiểm soát hơn nhờ mô hình rõ ràng |
|
Chi phí lưu trữ |
Thường tối ưu cho khối lượng dữ liệu lớn |
Chi phí gắn với lưu trữ và năng lực truy vấn đã tối ưu |
|
Khả năng thay đổi mô hình |
Cao |
Cần kiểm soát vì có thể ảnh hưởng báo cáo hiện hữu |
Bảng so sánh cho thấy sự đánh đổi quan trọng: Data Lake tăng tính linh hoạt bằng cách trì hoãn việc mô hình hóa, còn Data Warehouse tăng tính nhất quán bằng cách chuẩn hóa dữ liệu trước khi sử dụng.
Hiệu năng truy vấn khác nhau như thế nào?
Data Warehouse được thiết kế để phục vụ truy vấn phân tích có cấu trúc. Hệ thống thường sử dụng lưu trữ theo cột, phân vùng, thống kê dữ liệu, bộ nhớ đệm và cơ chế tối ưu truy vấn. Nhờ đó, các truy vấn tổng hợp trên lượng dữ liệu lớn có thể được thực hiện ổn định mà người dùng không cần quản lý trực tiếp từng tệp.
Data Lake có thể đạt hiệu năng cao nếu dữ liệu được tổ chức đúng. Các yếu tố ảnh hưởng gồm:
· Định dạng tệp
· Kích thước tệp
· Cách phân vùng
· Mức độ nén
· Metadata
· Khả năng loại bỏ vùng dữ liệu không liên quan
· Năng lực của công cụ xử lý
Ví dụ, truy vấn trên nhiều triệu tệp nhỏ thường gây chi phí đọc metadata và lập kế hoạch lớn hơn so với truy vấn trên số lượng tệp tối ưu. Tương tự, dữ liệu được lưu theo định dạng cột thường phù hợp với truy vấn phân tích hơn dữ liệu văn bản chưa nén.
Vì vậy, nhận định “Data Lake luôn chậm” không chính xác. Hiệu năng thấp thường xuất hiện khi dữ liệu chỉ được lưu lại mà chưa có chiến lược định dạng, phân vùng và tối ưu hóa. Dù vậy, Data Warehouse vẫn có lợi thế đối với khối lượng công việc BI lặp lại vì toàn bộ mô hình đã được thiết kế cho mục đích này.
Chất lượng và quản trị dữ liệu khác nhau ra sao?
Data Warehouse thường áp dụng quy tắc chất lượng trước khi dữ liệu trở thành nguồn báo cáo chính thức. Các quy tắc có thể kiểm tra:
· Kiểu dữ liệu
· Giá trị bắt buộc
· Bản ghi trùng lặp
· Quan hệ giữa các bảng
· Mã nghiệp vụ
· Tính đầy đủ theo thời gian
· Logic tính chỉ số
Do dữ liệu được chuẩn hóa trước, người dùng có thể sử dụng các bảng và chỉ số với mức tin cậy cao hơn trong phạm vi đã được kiểm soát.
Data Lake tiếp nhận nhiều loại dữ liệu hơn nên yêu cầu quản trị phức tạp hơn. Một hệ thống Data Lake hiệu quả cần có danh mục dữ liệu, metadata kỹ thuật, metadata nghiệp vụ, phân loại độ nhạy, kiểm soát truy cập và theo dõi nguồn gốc dữ liệu.
Nếu chỉ tập trung vào khả năng lưu trữ mà bỏ qua quản trị, tổ chức có thể không biết tập dữ liệu nào còn hiệu lực, trường dữ liệu mang ý nghĩa gì hoặc kết quả phân tích có thể được sử dụng cho quyết định nào.
Điểm cần hiểu đúng là Data Lake không đồng nghĩa với dữ liệu chất lượng thấp. Nó chỉ cho phép lưu dữ liệu trước nhiều bước chuẩn hóa hơn. Chất lượng cuối cùng phụ thuộc vào kiến trúc quản trị và lớp dữ liệu mà người dùng khai thác.
Data Lake có rẻ hơn Data Warehouse không?
Data Lake thường sử dụng lớp lưu trữ có khả năng mở rộng với chi phí trên mỗi đơn vị dung lượng thấp. Điều này phù hợp với dữ liệu lịch sử, nhật ký và dữ liệu có giá trị chưa được xác định ngay.
Tuy nhiên, chi phí lưu trữ chỉ là một phần của tổng chi phí. Một Data Lake thiếu tổ chức có thể phát sinh thêm chi phí cho:
· Quét lượng dữ liệu lớn
· Xử lý lại dữ liệu nhiều lần
· Duy trì nhiều bản sao
· Tìm kiếm dữ liệu phù hợp
· Khắc phục lỗi chất lượng
· Quản lý phân quyền và tuân thủ
Data Warehouse có thể yêu cầu đầu tư nhiều hơn cho năng lực truy vấn và mô hình hóa, nhưng đổi lại người dùng mất ít công sức hơn khi thực hiện các phân tích đã được chuẩn hóa.
Do đó, không nên kết luận Data Lake luôn rẻ hơn. Data Lake thường có lợi thế về chi phí lưu trữ dữ liệu quy mô lớn, còn Data Warehouse có thể tối ưu tổng chi phí cho các báo cáo ổn định vì giảm công việc xử lý lặp lại của người dùng.
Khi nào nên sử dụng Data Lake?
Data Lake phù hợp khi dữ liệu có mức đa dạng cao, nhu cầu phân tích chưa ổn định hoặc tổ chức cần bảo toàn dữ liệu nguồn.
Nên ưu tiên Data Lake khi:
· Dữ liệu đến từ nhiều hệ thống và định dạng khác nhau
· Tổ chức cần lưu log, sự kiện, hình ảnh hoặc dữ liệu cảm biến
· Nhóm dữ liệu thường xuyên thử nghiệm mô hình mới
· Nhu cầu học máy chiếm vai trò quan trọng
· Dữ liệu cần được tái xử lý theo nhiều logic
· Chưa thể xác định trước toàn bộ trường hợp sử dụng
Việc lựa chọn Data Lake chỉ hợp lý khi tổ chức đồng thời đầu tư vào metadata, quản trị, bảo mật và tiêu chuẩn tổ chức dữ liệu. Khả năng tiếp nhận nhanh không thể thay thế các cơ chế này.
Khi nào nên sử dụng Data Warehouse?
Data Warehouse phù hợp khi doanh nghiệp cần một nguồn dữ liệu thống nhất cho phân tích và báo cáo.
Nên ưu tiên Data Warehouse khi:
· Các chỉ số kinh doanh cần định nghĩa nhất quán
· Báo cáo được sử dụng lặp lại
· Người dùng chính không phải chuyên gia xử lý dữ liệu
· Dữ liệu cần hỗ trợ kiểm toán hoặc truy vết
· Tốc độ và độ ổn định của truy vấn BI có vai trò quan trọng
· Các phòng ban cần sử dụng chung một mô hình dữ liệu
Data Warehouse đặc biệt có giá trị khi một câu hỏi kinh doanh phải cho cùng một kết quả dù được truy vấn bởi nhiều nhóm khác nhau. Điều này đòi hỏi quy tắc nghiệp vụ phải được thống nhất trước khi dữ liệu được công bố.
Có cần chọn một trong hai hệ thống không?
Data Lake và Data Warehouse không nhất thiết loại trừ nhau. Trong nhiều kiến trúc dữ liệu, hai hệ thống đảm nhiệm các giai đoạn khác nhau.
Data Lake có thể tiếp nhận và lưu dữ liệu chi tiết từ nhiều nguồn. Sau đó, một phần dữ liệu được làm sạch, tổng hợp và nạp vào Data Warehouse để phục vụ báo cáo. Dữ liệu thô vẫn được giữ lại cho các nhu cầu khám phá hoặc tái xử lý.
Luồng dữ liệu có thể diễn ra như sau:
1. Thu thập dữ liệu từ ứng dụng, thiết bị và hệ thống nghiệp vụ
2. Lưu dữ liệu gốc trong Data Lake
3. Kiểm tra chất lượng và chuẩn hóa dữ liệu
4. Xây dựng các tập dữ liệu đã xử lý
5. Nạp dữ liệu nghiệp vụ vào Data Warehouse
6. Cung cấp dữ liệu cho dashboard, báo cáo và mô hình phân tích
Cách kết hợp này cho phép tổ chức vừa giữ được tính linh hoạt của dữ liệu nguồn, vừa duy trì tính nhất quán của hệ thống báo cáo.
Một số kiến trúc hiện đại còn cố gắng đưa khả năng quản lý bảng, giao dịch và tối ưu truy vấn vào môi trường lưu trữ dữ liệu linh hoạt. Dù công nghệ có thể làm ranh giới kỹ thuật bớt rõ, câu hỏi thiết kế cơ bản vẫn không thay đổi: dữ liệu đang được lưu để khám phá linh hoạt hay để sử dụng như một sản phẩm dữ liệu đã chuẩn hóa.
Những hiểu lầm thường gặp khi so sánh Data Lake và Data Warehouse
Data Lake không phải nơi đổ dữ liệu tùy ý
Khả năng lưu dữ liệu thô không có nghĩa là có thể bỏ qua cấu trúc. Data Lake vẫn cần phân vùng, metadata, kiểm soát truy cập, quản lý vòng đời và quy tắc chất lượng. Nếu thiếu các yếu tố này, dữ liệu khó tái sử dụng và chi phí xử lý tăng lên.
Data Warehouse không chỉ lưu dữ liệu cũ
Tên gọi “warehouse” đôi khi khiến người đọc cho rằng hệ thống chỉ chứa dữ liệu lịch sử. Trên thực tế, tần suất cập nhật phụ thuộc kiến trúc xử lý. Data Warehouse có thể được cập nhật theo lô, theo các khoảng thời gian ngắn hoặc gần thời gian thực.
Dữ liệu thô không mặc nhiên có giá trị cao hơn
Dữ liệu thô bảo toàn nhiều chi tiết, nhưng chưa chắc phù hợp để ra quyết định. Đối với báo cáo quản trị, dữ liệu đã được kiểm tra và chuẩn hóa thường hữu ích hơn vì giảm nguy cơ mỗi nhóm diễn giải theo một cách khác nhau.
Dữ liệu đã chuẩn hóa không phù hợp với mọi mục tiêu
Quá trình chuẩn hóa có thể loại bỏ chi tiết không cần thiết cho báo cáo hiện tại nhưng có ích cho một nghiên cứu sau này. Vì vậy, chỉ lưu phiên bản đã tổng hợp có thể làm giảm khả năng khám phá và tái xử lý.
Data Lake và Data Warehouse khác nhau chủ yếu ở cách dữ liệu được cấu trúc và chuẩn bị. Data Lake lưu dữ liệu đa dạng ở trạng thái thô hoặc bán xử lý, thường áp dụng cấu trúc khi đọc và phù hợp với khám phá dữ liệu, xử lý quy mô lớn तथा học máy. Data Warehouse áp dụng cấu trúc trước khi lưu, tập trung vào dữ liệu đã chuẩn hóa và phù hợp với BI, báo cáo quản trị cùng các chỉ số nghiệp vụ ổn định.
Lựa chọn phù hợp không phụ thuộc vào việc công nghệ nào hiện đại hơn. Tổ chức cần xác định dữ liệu được lưu để khám phá linh hoạt hay để cung cấp kết quả phân tích nhất quán. Khi cả hai nhu cầu cùng tồn tại, Data Lake và Data Warehouse có thể được kết hợp thành các lớp bổ trợ thay vì được xem là hai phương án loại trừ nhau.
Hỏi đáp về Data Lake và Data Warehouse
Data Lake có thể thay thế hoàn toàn Data Warehouse không?
Không phải trong mọi trường hợp. Data Lake có thể cung cấp khả năng truy vấn và quản lý dữ liệu nâng cao, nhưng báo cáo nghiệp vụ vẫn cần các định nghĩa, mô hình và quy tắc chất lượng thống nhất. Dù dữ liệu nằm ở đâu, tổ chức vẫn phải xây dựng một lớp dữ liệu đã được chuẩn hóa cho người dùng BI.
Data Warehouse có thể lưu dữ liệu phi cấu trúc không?
Một số nền tảng có thể lưu hoặc liên kết với dữ liệu phi cấu trúc, nhưng đây thường không phải mô hình sử dụng cốt lõi của Data Warehouse. Hệ thống vẫn phát huy giá trị lớn nhất khi xử lý dữ liệu có cấu trúc và các truy vấn phân tích rõ ràng.
Doanh nghiệp nhỏ nên bắt đầu với Data Lake hay Data Warehouse?
Doanh nghiệp có nhu cầu chủ yếu là dashboard, doanh thu và báo cáo vận hành thường nhận được giá trị nhanh hơn từ một Data Warehouse có phạm vi rõ ràng. Data Lake phù hợp hơn khi doanh nghiệp thực sự có dữ liệu đa dạng, nhu cầu học máy hoặc yêu cầu lưu giữ lượng lớn dữ liệu chi tiết.

GỬI Ý KIẾN BÌNH LUẬN
