
Hadoop đóng vai trò gì trong hệ sinh thái Big Data?
Mục lục
Hadoop là nền tảng mã nguồn mở giúp lưu trữ và xử lý dữ liệu phân tán trên nhiều máy chủ, đóng vai trò quan trọng trong hệ sinh thái Big Data nhờ khả năng mở rộng, tính sẵn sàng cao và tối ưu chi phí hạ tầng.
Hadoop là một framework mã nguồn mở được thiết kế để lưu trữ, quản lý và xử lý khối lượng dữ liệu rất lớn (Big Data) trên cụm nhiều máy tính thông thường (cluster). Thay vì phụ thuộc vào một máy chủ có cấu hình mạnh, Hadoop phân tán dữ liệu và tác vụ xử lý lên nhiều node, từ đó tăng khả năng mở rộng, cải thiện hiệu suất và đảm bảo hệ thống vẫn hoạt động ngay cả khi một số máy gặp sự cố.
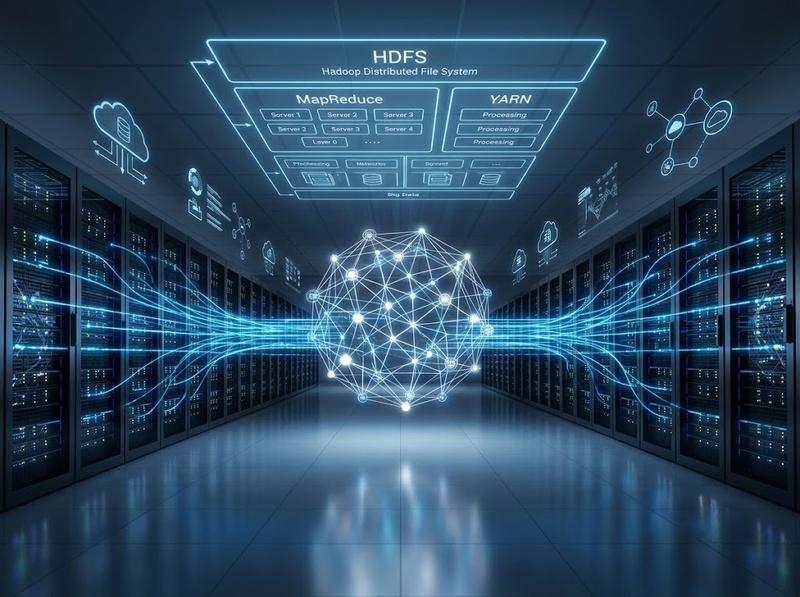
Trong hệ sinh thái Big Data, Hadoop đóng vai trò là nền tảng hạ tầng giúp doanh nghiệp xây dựng các hệ thống phân tích dữ liệu quy mô lớn, phục vụ các nhu cầu như phân tích hành vi khách hàng, xử lý log, phân tích dữ liệu IoT, trí tuệ nhân tạo và học máy.
Hadoop là gì?
Hadoop là một framework được phát triển dựa trên ý tưởng xử lý dữ liệu phân tán. Mục tiêu của Hadoop là cho phép lưu trữ và xử lý dữ liệu có dung lượng từ hàng terabyte (TB) đến petabyte (PB) trên nhiều máy tính hoạt động đồng thời.
Thay vì tập trung toàn bộ dữ liệu vào một máy chủ, Hadoop chia dữ liệu thành nhiều khối nhỏ (block) và phân phối chúng đến nhiều node trong cluster. Khi cần xử lý, các node sẽ thực hiện song song, giúp giảm đáng kể thời gian xử lý so với mô hình tập trung.
Những đặc điểm nổi bật của Hadoop gồm:
· Khả năng mở rộng bằng cách bổ sung thêm node
· Chi phí triển khai thấp nhờ sử dụng phần cứng phổ thông
· Khả năng chịu lỗi cao thông qua cơ chế sao lưu dữ liệu
· Xử lý dữ liệu song song với quy mô lớn
· Phù hợp với cả dữ liệu có cấu trúc, bán cấu trúc và phi cấu trúc
Hadoop hoạt động như thế nào trong Big Data?
Cơ chế hoạt động của Hadoop dựa trên hai nguyên tắc chính:
Lưu trữ dữ liệu phân tán với HDFS
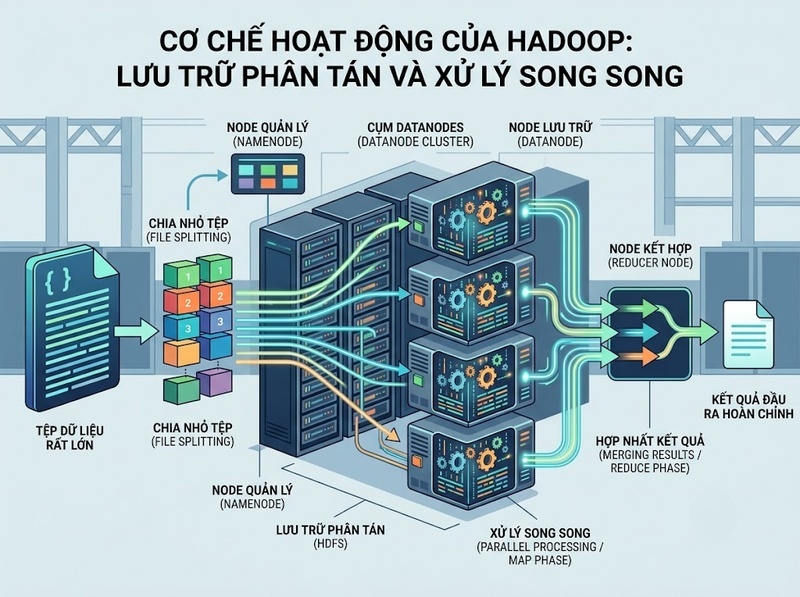
Hadoop Distributed File System (HDFS) chia một tệp lớn thành nhiều block, sau đó lưu các block này trên nhiều DataNode khác nhau.
Mỗi block thường được sao chép thành nhiều bản trên các node khác nhau để đảm bảo:
· Không mất dữ liệu khi một node gặp sự cố
· Hệ thống vẫn tiếp tục hoạt động
· Tăng tính sẵn sàng của dữ liệu
NodeMaster (NameNode) quản lý metadata của toàn bộ hệ thống, trong khi DataNode chịu trách nhiệm lưu trữ dữ liệu thực tế.
Xử lý dữ liệu phân tán
Khi có yêu cầu xử lý dữ liệu, Hadoop sẽ:
1. Chia bài toán thành nhiều tác vụ nhỏ
2. Phân phối các tác vụ tới nhiều node
3. Thực hiện xử lý song song
4. Tổng hợp kết quả cuối cùng
Cách tiếp cận này giúp giảm thời gian xử lý đối với các tập dữ liệu cực lớn so với việc xử lý trên một máy đơn lẻ.
Các thành phần chính của Hadoop
HDFS (Hadoop Distributed File System)
Đây là hệ thống lưu trữ phân tán của Hadoop.
Nhiệm vụ chính:
· Lưu trữ dữ liệu quy mô lớn
· Chia dữ liệu thành nhiều block
· Sao lưu dữ liệu giữa các node
· Đảm bảo khả năng chịu lỗi
YARN (Yet Another Resource Negotiator)
YARN là lớp quản lý tài nguyên của Hadoop.
Vai trò gồm:
· Phân bổ CPU và bộ nhớ
· Quản lý tiến trình xử lý
· Điều phối tài nguyên giữa các ứng dụng
Nhờ YARN, nhiều tác vụ có thể chạy đồng thời trên cùng một cluster.
MapReduce
MapReduce là mô hình xử lý dữ liệu phân tán.
Quá trình xử lý gồm hai giai đoạn:
· Map: Chia nhỏ dữ liệu và xử lý từng phần
· Reduce: Tổng hợp kết quả từ các phần đã xử lý
Cơ chế này đặc biệt hiệu quả với các bài toán thống kê, phân tích dữ liệu và tổng hợp báo cáo quy mô lớn.
Hadoop Common
Đây là tập hợp các thư viện và tiện ích dùng chung, hỗ trợ các thành phần khác của Hadoop hoạt động thống nhất.
Vai trò của Hadoop trong hệ sinh thái Big Data
Là nền tảng lưu trữ dữ liệu khổng lồ
Một trong những vai trò quan trọng nhất của Hadoop là lưu trữ dữ liệu với quy mô rất lớn mà không cần đầu tư các hệ thống lưu trữ chuyên dụng có chi phí cao.
Điều này giúp doanh nghiệp dễ dàng mở rộng dung lượng lưu trữ theo nhu cầu thực tế.
Hỗ trợ xử lý dữ liệu phân tán
Hadoop cho phép nhiều máy tính cùng xử lý một tập dữ liệu, giúp:
· Giảm thời gian tính toán
· Tăng hiệu năng
· Khai thác hiệu quả tài nguyên phần cứng
Tăng khả năng mở rộng
Khi dữ liệu tăng trưởng, doanh nghiệp chỉ cần bổ sung thêm node vào cluster thay vì thay thế toàn bộ hạ tầng.
Đây là ưu điểm nổi bật giúp Hadoop phù hợp với các hệ thống Big Data liên tục mở rộng.
Đảm bảo tính sẵn sàng của hệ thống
Nhờ cơ chế sao chép dữ liệu trên nhiều node, Hadoop vẫn có thể hoạt động khi một hoặc nhiều máy chủ gặp sự cố.
Điều này làm giảm nguy cơ gián đoạn dịch vụ và mất dữ liệu.
Là nền tảng cho nhiều công nghệ Big Data khác
Hadoop thường được kết hợp với nhiều công nghệ như:
· Apache Spark
· Hive
· HBase
· Pig
· Kafka
Sự kết hợp này tạo thành hệ sinh thái phục vụ lưu trữ, xử lý, truy vấn và phân tích dữ liệu toàn diện.
Ưu điểm của Hadoop trong Big Data
Một số lợi ích nổi bật gồm:
· Mở rộng gần như không giới hạn
· Hỗ trợ dữ liệu đa định dạng
· Khả năng chịu lỗi cao
· Tận dụng phần cứng phổ thông
· Chi phí triển khai thấp
· Xử lý dữ liệu song song hiệu quả
· Phù hợp với doanh nghiệp có lượng dữ liệu tăng trưởng nhanh
Hạn chế của Hadoop
Mặc dù có nhiều ưu điểm, Hadoop vẫn tồn tại một số hạn chế:
· MapReduce không phù hợp với các tác vụ yêu cầu phản hồi theo thời gian thực
· Quản trị cluster phức tạp khi quy mô lớn
· Tiêu tốn tài nguyên lưu trữ do cơ chế sao chép dữ liệu
· Hiệu quả thấp đối với các tác vụ xử lý dữ liệu nhỏ
· Nhiều doanh nghiệp hiện nay ưu tiên Apache Spark cho các bài toán phân tích thời gian thực
Hadoop được ứng dụng ở đâu?
Hadoop được sử dụng trong nhiều lĩnh vực cần xử lý dữ liệu quy mô lớn:
· Phân tích hành vi khách hàng
· Phân tích dữ liệu thương mại điện tử
· Xử lý log hệ thống
· Phân tích dữ liệu mạng xã hội
· Phân tích dữ liệu IoT
· Phân tích tài chính và ngân hàng
· Phát hiện gian lận
· Hỗ trợ mô hình học máy và AI
· Phân tích dữ liệu y tế
Hadoop vẫn là một trong những nền tảng quan trọng nhất của hệ sinh thái Big Data nhờ khả năng lưu trữ và xử lý dữ liệu phân tán trên quy mô lớn. Mặc dù nhiều công nghệ mới đã xuất hiện để bổ sung hoặc thay thế trong một số trường hợp, Hadoop vẫn đóng vai trò là nền tảng hạ tầng cho nhiều hệ thống dữ liệu hiện đại. Việc hiểu rõ cách Hadoop hoạt động, các thành phần cốt lõi và vai trò của nó sẽ giúp doanh nghiệp lựa chọn kiến trúc Big Data phù hợp với nhu cầu lưu trữ và phân tích dữ liệu.
Hỏi đáp về Hadoop trong Big Data
Hadoop có phải là cơ sở dữ liệu không?
Không. Hadoop là framework lưu trữ và xử lý dữ liệu phân tán, không phải hệ quản trị cơ sở dữ liệu.
Hadoop có còn được sử dụng hiện nay không?
Có. Hadoop vẫn được sử dụng rộng rãi trong các hệ thống Big Data, đặc biệt cho lưu trữ phân tán và xử lý dữ liệu theo lô (batch processing).
Hadoop và Apache Spark khác nhau như thế nào?
Hadoop cung cấp nền tảng lưu trữ và xử lý phân tán, trong khi Apache Spark tập trung vào xử lý dữ liệu tốc độ cao, đặc biệt phù hợp với phân tích thời gian thực và xử lý dữ liệu trong bộ nhớ.
Hadoop có phù hợp với doanh nghiệp nhỏ không?
Có, nếu doanh nghiệp dự kiến xử lý dữ liệu lớn và cần khả năng mở rộng lâu dài. Tuy nhiên, với khối lượng dữ liệu nhỏ, việc triển khai Hadoop có thể chưa mang lại hiệu quả về chi phí.
Thành phần nào quan trọng nhất của Hadoop?
Ba thành phần cốt lõi gồm HDFS (lưu trữ phân tán), YARN (quản lý tài nguyên) và MapReduce (xử lý dữ liệu phân tán), phối hợp để tạo nên nền tảng xử lý Big Data hoàn chỉnh.

GỬI Ý KIẾN BÌNH LUẬN
