
Multi Cloud được triển khai theo kiến trúc nào?
Mục lục
- Kiến trúc Multi Cloud gồm những lớp nào?
- Các mô hình phân bổ workload trong Multi Cloud
- Kết nối mạng và định tuyến liên cloud vận hành ra sao?
- Danh tính, chính sách và hạ tầng được quản lý thống nhất thế nào?
- Dữ liệu là phần khó nhất của kiến trúc Multi Cloud
- Quan sát, bảo mật và vận hành nhiều cloud cần một lớp chung
- Khi nào Multi Cloud phù hợp và khi nào không?
Multi Cloud cho phép doanh nghiệp sử dụng nhiều nền tảng đám mây trong cùng một hệ thống, nhưng giá trị chỉ xuất hiện khi workload, mạng, danh tính, dữ liệu và lớp quản trị được thiết kế thành các miền vận hành rõ ràng. Bài viết giải thích kiến trúc Multi Cloud, các mô hình triển khai và cách kiểm soát độ phức tạp khi vận hành nhiều cloud.
Multi Cloud là mô hình sử dụng dịch vụ từ hai nhà cung cấp đám mây trở lên để vận hành ứng dụng, dữ liệu hoặc các năng lực hạ tầng trong cùng một chiến lược công nghệ. Một doanh nghiệp có thể đặt hệ thống giao dịch trên một cloud, nền tảng phân tích trên cloud khác và vẫn được xem là Multi Cloud; không bắt buộc cùng một ứng dụng phải chạy đồng thời trên mọi cloud.
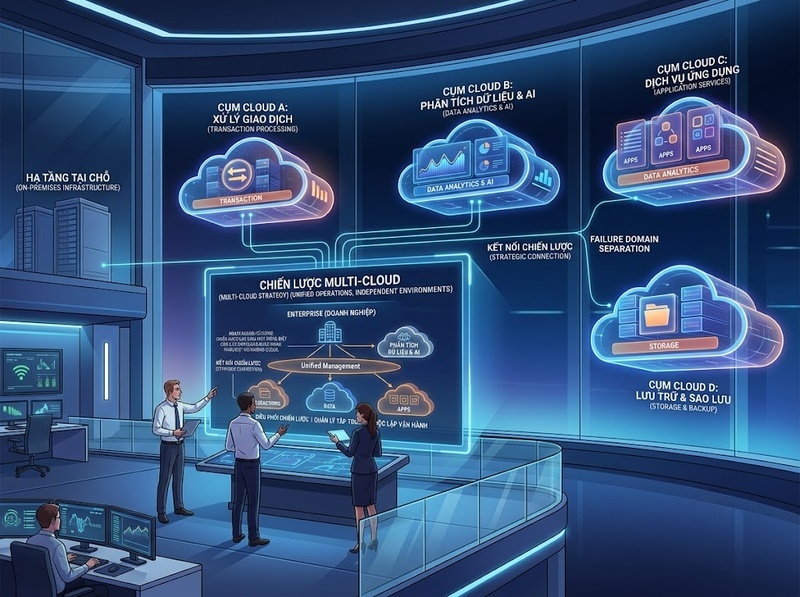
Vì vậy, Multi Cloud không phải một kiến trúc duy nhất. Cách triển khai phù hợp thường là một kiến trúc phân lớp, trong đó workload được phân bổ theo yêu cầu kinh doanh, còn mạng, danh tính, chính sách, dữ liệu và quan sát hệ thống được tổ chức thành các lớp có thể quản trị nhất quán. Mục tiêu không phải “dàn đều” tài nguyên lên nhiều cloud, mà là kiểm soát rõ failure domain, giảm phụ thuộc không cần thiết và chỉ tạo liên kết giữa các cloud ở nơi thực sự mang lại giá trị.
Điểm quan trọng là phân biệt Multi Cloud với Hybrid Cloud. Multi Cloud nói về việc sử dụng nhiều nền tảng cloud, còn Hybrid Cloud nhấn mạnh sự kết hợp giữa cloud với môi trường private cloud hoặc hạ tầng tại chỗ. Hai mô hình có thể xuất hiện đồng thời, nhưng không đồng nghĩa với nhau.
Kiến trúc Multi Cloud gồm những lớp nào?
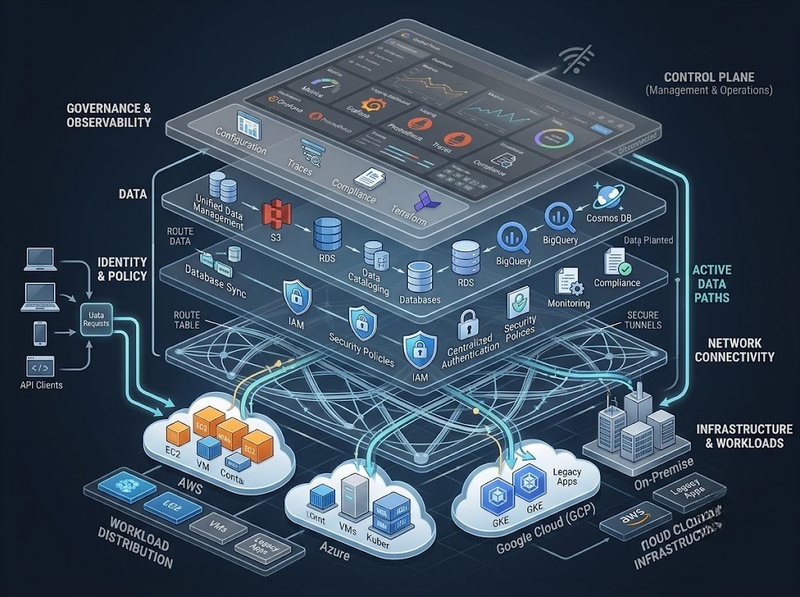
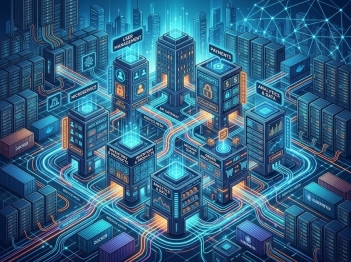
Một kiến trúc Multi Cloud có thể được nhìn như năm lớp chính: lớp workload, lớp kết nối, lớp danh tính và chính sách, lớp dữ liệu, cùng lớp quản trị và quan sát. Các lớp này không nhất thiết được cung cấp bởi một công cụ duy nhất. Điều cần thống nhất là nguyên tắc vận hành và ranh giới trách nhiệm.
Lớp workload quyết định ứng dụng hoặc dịch vụ nào chạy ở cloud nào. Đây là nơi doanh nghiệp xác định failure domain, yêu cầu hiệu năng, vùng địa lý, dịch vụ chuyên biệt và mức độ cần khả chuyển.
Lớp kết nối xử lý DNS, định tuyến, cân bằng tải, kết nối riêng, VPN, firewall và luồng giao tiếp giữa các môi trường. Một kiến trúc tốt cố gắng giữ đường truyền dữ liệu của ứng dụng ngắn và cục bộ, thay vì buộc mọi request phải đi qua một điểm trung tâm.
Lớp danh tính và chính sách tạo ra cách xác thực thống nhất cho người dùng và workload, đồng thời áp dụng các quy tắc về quyền truy cập, cấu hình, mã hóa, tagging và tuân thủ.
Lớp dữ liệu quyết định dữ liệu nằm ở đâu, được sao chép như thế nào, nhất quán đến mức nào và hệ thống chấp nhận mất bao nhiêu dữ liệu khi xảy ra sự cố.
Lớp quản trị và quan sát cung cấp inventory, Infrastructure as Code, policy as code, logging, metrics, tracing, cảnh báo, quản lý chi phí và quy trình sự cố trên toàn bộ môi trường.
Data plane và control plane cần được tách biệt
Một nguyên tắc hữu ích là phân biệt data plane với control plane. Data plane là nơi request, packet và dữ liệu nghiệp vụ thực sự được xử lý. Control plane là nơi khai báo cấu hình, chính sách, triển khai, inventory và trạng thái quản trị.
Trong Multi Cloud, control plane có thể được hợp nhất để tạo trải nghiệm quản trị nhất quán, nhưng data plane không nên phụ thuộc tuyệt đối vào một điểm điều khiển trung tâm. Nếu control plane gặp sự cố, các workload đang hoạt động vẫn nên tiếp tục phục vụ trong phạm vi có thể. Cách tách này giảm nguy cơ biến công cụ quản trị chung thành single point of failure mới.
Các mô hình phân bổ workload trong Multi Cloud
Multi Cloud có thể được triển khai theo nhiều topology khác nhau. Việc chọn topology nên bắt đầu từ yêu cầu của workload thay vì từ mong muốn “phải dùng nhiều cloud”.
Phân bổ độc lập theo workload
Đây là mô hình đơn giản nhất. Mỗi nhóm ứng dụng hoặc năng lực được đặt ở cloud phù hợp nhất và chỉ tích hợp qua API, sự kiện hoặc luồng dữ liệu cần thiết. Ví dụ, hệ thống giao dịch có thể ở một cloud trong khi nền tảng phân tích chạy ở cloud khác.
Ưu điểm lớn nhất là giảm coupling thời gian chạy. Sự cố ở một nhà cung cấp không nhất thiết kéo theo toàn bộ hệ thống. Đổi lại, doanh nghiệp phải chấp nhận việc một số workload không thể chuyển tức thời sang cloud khác.
Primary–secondary cho dự phòng
Một cloud giữ vai trò chính, cloud thứ hai duy trì năng lực khôi phục. Dữ liệu và cấu hình được sao chép theo RPO và RTO đã định nghĩa. Mô hình này phù hợp khi mục tiêu chính là khả năng phục hồi, nhưng không cần trả chi phí vận hành toàn bộ tải ở hai cloud cùng lúc.
Điểm khó không nằm ở việc “có bản sao”, mà ở khả năng chuyển đổi thực tế. DNS, secrets, certificate, dữ liệu, queue, dependency và runbook đều phải sẵn sàng. Nếu failover chưa từng được kiểm thử, kiến trúc dự phòng mới chỉ tồn tại trên sơ đồ.
Active–active trên nhiều cloud
Cùng một dịch vụ được triển khai ở ít nhất hai cloud và nhận lưu lượng đồng thời. Mô hình này có thể tăng khả năng chịu lỗi, nhưng chỉ khi lớp định tuyến, trạng thái phiên và dữ liệu được thiết kế tương ứng.
Một SLO 99,9% cho phép khoảng 43,2 phút gián đoạn trong 30 ngày; 99,99% chỉ còn khoảng 4,32 phút. Nếu thời gian phát hiện, chuyển lưu lượng và khôi phục kéo dài hơn error budget, việc có hai cloud không tự động tạo ra mức sẵn sàng cao hơn.
Active–active cũng dễ làm phát sinh bài toán consistency. Nếu hai cloud cùng ghi vào một tập dữ liệu nhưng kết nối liên cloud không ổn định, hệ thống phải có quy tắc rõ ràng về conflict, quorum, eventual consistency hoặc quyền sở hữu dữ liệu theo vùng.
Dùng dịch vụ chuyên biệt từ nhiều cloud
Một ứng dụng có thể sử dụng compute ở cloud A nhưng gọi một dịch vụ AI, dữ liệu hoặc bảo mật ở cloud B. Mô hình này khai thác thế mạnh riêng của từng nền tảng, song tạo dependency xuyên cloud trong runtime.
Nếu dependency đó nằm trên critical path, độ trễ mạng, egress và sự cố của cả hai nhà cung cấp đều có thể tác động đến một request. Vì thế, dịch vụ xuyên cloud nên được đặt sau cơ chế cache, queue, retry hoặc degradation khi phù hợp, thay vì tạo chuỗi gọi đồng bộ quá dài.
Kết nối mạng và định tuyến liên cloud vận hành ra sao?
Mạng là lớp liên kết các failure domain vốn tách biệt. Thiết kế mạng Multi Cloud thường phải giải quyết ba bài toán: địa chỉ không xung đột, kết nối tin cậy và định tuyến lưu lượng theo ý đồ.
Trước hết, không gian IP nên được hoạch định từ đầu để tránh CIDR overlap. Khi hai VPC hoặc VNet sử dụng dải địa chỉ trùng nhau, việc peering, route advertisement và kiểm soát firewall trở nên phức tạp hơn, đôi khi buộc phải thêm NAT hoặc lớp proxy chỉ để khắc phục lỗi thiết kế địa chỉ.
Kết nối giữa các cloud có thể dùng Internet được mã hóa, site-to-site VPN hoặc đường kết nối riêng thông qua nhà mạng và điểm trao đổi. Lựa chọn phụ thuộc vào throughput, độ trễ, yêu cầu bảo mật, chi phí và khả năng dự phòng. Không có một loại đường truyền luôn tốt nhất cho mọi workload.
Ở lớp lưu lượng ứng dụng, DNS và global traffic management thường quyết định người dùng được đưa đến cloud nào. Với active–active, health check phải đánh giá được trạng thái thật của dịch vụ, không chỉ kiểm tra một endpoint còn trả HTTP 200. Với primary–secondary, TTL, cache DNS và thời gian hội tụ phải được tính vào RTO.
Một sai lầm phổ biến là tập trung toàn bộ lưu lượng qua một hub duy nhất để “dễ quản lý”. Cách này đơn giản hóa chính sách nhưng có thể tạo hairpin traffic, tăng latency và biến hub thành điểm lỗi chung. Kiến trúc hợp lý thường quản trị tập trung nhưng cho phép đường dữ liệu đi trực tiếp theo khu vực hoặc theo cloud khi chính sách cho phép.
Danh tính, chính sách và hạ tầng được quản lý thống nhất thế nào?
Quản lý Multi Cloud hiệu quả không có nghĩa là làm cho mọi nền tảng giống hệt nhau. Mục tiêu thực tế hơn là tạo một lớp nguyên tắc chung, sau đó ánh xạ nguyên tắc đó vào cơ chế bản địa của từng cloud.
Danh tính người dùng nên được liên kết về một nguồn nhận diện doanh nghiệp thay vì tạo tài khoản độc lập ở từng cloud. Với workload, ưu tiên credential ngắn hạn và workload identity thay cho access key tồn tại lâu. Cách này giảm phạm vi rò rỉ bí mật và giúp thu hồi quyền tập trung hơn.
Quyền truy cập cần tuân theo least privilege, nhưng tên role và permission ở mỗi nhà cung cấp có thể khác nhau. Vì vậy, doanh nghiệp nên chuẩn hóa theo intent — chẳng hạn “được đọc log của production” — rồi ánh xạ intent đó sang permission cụ thể của từng cloud, thay vì cố ép mọi nền tảng dùng cùng một mô hình IAM.
Hạ tầng nên được khai báo bằng Infrastructure as Code để môi trường có thể tái tạo, review và phát hiện drift. Các module chung có thể chuẩn hóa naming, tagging, encryption, network baseline và logging. Tuy nhiên, trừu tượng hóa quá mức lại tạo “mẫu số chung thấp nhất”, khiến doanh nghiệp không tận dụng được dịch vụ bản địa có giá trị.
Policy as code bổ sung một lớp kiểm soát trước và sau triển khai. Chính sách có thể chặn tài nguyên public ngoài ý muốn, yêu cầu mã hóa, bắt buộc log hoặc kiểm soát vùng được phép triển khai. Điểm cốt lõi là cùng một mục tiêu kiểm soát phải có cách đo và kiểm chứng tương đương trên mọi cloud.
Dữ liệu là phần khó nhất của kiến trúc Multi Cloud
Compute có thể được đóng gói và triển khai lại tương đối dễ; dữ liệu thì không. Dữ liệu có kích thước, trạng thái, yêu cầu consistency, quy định lưu trú và chi phí di chuyển. Vì vậy, thiết kế Multi Cloud nên xác định chiến lược dữ liệu trước khi quyết định rằng một ứng dụng “có thể chạy ở bất kỳ cloud nào”.
RPO và RTO quyết định cách sao chép
RPO xác định lượng dữ liệu tối đa có thể mất tính theo thời gian. RTO xác định khoảng thời gian tối đa để dịch vụ được khôi phục. Hai chỉ số này trực tiếp quyết định topology dữ liệu.
Nếu RPO gần bằng 0 giữa hai cloud, hệ thống thường cần replication đồng bộ hoặc cơ chế đồng thuận phân tán. Đổi lại, latency của đường liên cloud đi vào critical path và một sự cố mạng có thể ảnh hưởng đến khả năng ghi. Nếu chấp nhận RPO lớn hơn 0, replication bất đồng bộ giúp tách failure domain tốt hơn nhưng có nguy cơ mất phần dữ liệu chưa kịp đồng bộ khi failover.
Không nên mặc định rằng mọi cơ sở dữ liệu phải active–active. Với nhiều workload, một nguồn ghi chính cùng replica bất đồng bộ sang cloud dự phòng tạo cân bằng tốt hơn giữa consistency, latency và khả năng phục hồi.
Data gravity giới hạn tính khả chuyển
Khi dữ liệu tăng lên, chi phí và thời gian di chuyển có thể trở thành yếu tố chi phối hơn cả khả năng triển khai compute. Một dịch vụ có thể được container hóa để chạy ở cloud khác trong vài phút, nhưng tập dữ liệu hàng chục terabyte không thể được xem như một artifact triển khai thông thường.
Do đó, khả chuyển workload phải được đánh giá cùng vị trí dữ liệu. Thiết kế tốt thường đưa compute đến gần dữ liệu, phân tách dữ liệu theo domain hoặc sử dụng API/sự kiện để chia sẻ phần cần thiết, thay vì sao chép toàn bộ dữ liệu giữa các cloud chỉ để đạt hình thức “đối xứng”.
Quan sát, bảo mật và vận hành nhiều cloud cần một lớp chung
Khi mỗi cloud có console, log format, IAM và hệ thống cảnh báo riêng, đội vận hành dễ mất bức tranh tổng thể. Một lớp vận hành chung cần trả lời được bốn câu hỏi: tài nguyên nào đang tồn tại, ai có quyền gì, hệ thống đang hoạt động ra sao và chi phí phát sinh ở đâu.
Telemetry nên được chuẩn hóa ở mức ứng dụng bằng các khái niệm chung như log có cấu trúc, metrics, distributed tracing và correlation ID. Công cụ thu thập có thể khác nhau, nhưng dữ liệu cần đủ nhất quán để một incident không phải được điều tra qua nhiều dashboard không liên kết.
Bảo mật cũng cần một baseline thống nhất: inventory tài sản, posture management, vulnerability management, encryption, secrets, audit log và quy trình phản ứng sự cố. Cách tiếp cận Zero Trust trong NIST SP 800-207 đặc biệt phù hợp với Multi Cloud vì quyết định truy cập dựa trên danh tính, trạng thái và policy thay vì giả định rằng tài nguyên “ở trong mạng nội bộ” thì đáng tin.
Ở góc độ vận hành, nên dùng cùng một mô hình SLO, severity, ownership và runbook trên mọi cloud. Một dịch vụ đạt SLO không phụ thuộc việc nó chạy ở nhà cung cấp nào; ngược lại, một kiến trúc dùng nhiều cloud nhưng không có cùng chuẩn đo lường sẽ rất khó chứng minh rằng độ tin cậy thực sự được cải thiện.
Quản lý chi phí cũng phải nhìn theo workload thay vì chỉ theo hóa đơn từng nhà cung cấp. Tagging, account structure và cost allocation nên đủ nhất quán để biết một sản phẩm đang tiêu tốn bao nhiêu trên toàn bộ môi trường, kể cả phí truyền dữ liệu giữa cloud.
Khi nào Multi Cloud phù hợp và khi nào không?
Multi Cloud phù hợp khi có một yêu cầu đủ mạnh để biện minh cho độ phức tạp bổ sung. Những yêu cầu thường có giá trị là phân tách failure domain, quy định lưu trú dữ liệu, nhu cầu sử dụng dịch vụ chuyên biệt, sáp nhập nhiều nền tảng sẵn có, phục vụ khách hàng ở vùng mà một nhà cung cấp không đáp ứng tốt hoặc duy trì khả năng chuyển đổi có kiểm chứng cho các workload quan trọng.
Ngược lại, Multi Cloud có thể làm hệ thống kém ổn định hơn nếu đội ngũ chưa có nền tảng về Infrastructure as Code, quản trị danh tính, quan sát tập trung và tự động hóa vận hành. Khi đó, số lượng tổ hợp lỗi tăng nhanh: lỗi ứng dụng, lỗi cloud, lỗi đường liên cloud, lỗi replication, lỗi policy và lỗi công cụ quản trị có thể xuất hiện đồng thời.
Một hiểu lầm khác là Multi Cloud đồng nghĩa với “không phụ thuộc nhà cung cấp”. Thực tế, tránh mọi dịch vụ bản địa thường buộc kiến trúc về mẫu số chung thấp nhất và làm mất lợi ích của cloud. Chiến lược tốt hơn là xác định phần nào cần khả chuyển và phần nào được phép tối ưu theo nền tảng. Workload có yêu cầu exit rõ ràng có thể dùng container, chuẩn mở và lớp trừu tượng phù hợp; workload cần năng lực chuyên biệt có thể chấp nhận coupling có chủ đích.
Vì vậy, quyết định triển khai Multi Cloud nên bắt đầu bằng ba câu hỏi: failure domain nào cần tách, dependency nào cần giữ cục bộ và dữ liệu nào thực sự phải di chuyển. Khi ba câu hỏi này chưa có câu trả lời cụ thể, việc thêm một cloud thường chỉ làm tăng bề mặt vận hành thay vì tạo thêm khả năng phục hồi.
Multi Cloud không phải một sơ đồ kiến trúc cố định mà là tập hợp các mô hình triển khai trên nhiều nền tảng cloud. Kiến trúc bền vững thường tách rõ workload, kết nối, danh tính và chính sách, dữ liệu, cùng lớp quản trị và quan sát; sau đó chọn topology độc lập, primary–secondary, active–active hoặc sử dụng dịch vụ chuyên biệt theo yêu cầu thực tế. Giá trị của Multi Cloud đến từ việc phân tách failure domain và quản trị nhất quán, không phải từ số lượng nhà cung cấp. Nếu không có mục tiêu về khả năng phục hồi, tuân thủ, năng lực chuyên biệt hoặc khả chuyển đủ rõ, một kiến trúc ít cloud hơn thường dễ vận hành và đáng tin cậy hơn.

GỬI Ý KIẾN BÌNH LUẬN
