
Các mô hình lưu trữ Big Data hoạt động như thế nào?
Mục lục
- Vì sao Big Data cần mô hình lưu trữ khác với cơ sở dữ liệu truyền thống?
- Hệ thống lưu trữ phân tán hoạt động như thế nào?
- Data Lake lưu trữ Big Data như thế nào?
- Data Warehouse khác gì Data Lake?
- Các thành phần thường xuất hiện trong kiến trúc lưu trữ Big Data
- Ưu điểm của mô hình lưu trữ Big Data
- Những thách thức khi lưu trữ Big Data
Tìm hiểu cách lưu trữ Big Data thông qua hệ thống phân tán, Data Lake và Data Warehouse. Bài viết giải thích cơ chế hoạt động, ưu nhược điểm và cách các mô hình này kết hợp để lưu trữ, quản lý và khai thác dữ liệu quy mô lớn.
Big Data không thể được lưu trữ theo cách truyền thống khi khối lượng dữ liệu tăng lên đến hàng terabyte hoặc petabyte và được tạo ra liên tục từ nhiều nguồn khác nhau. Để đáp ứng yêu cầu về khả năng mở rộng, hiệu năng và tính sẵn sàng, các hệ thống Big Data thường sử dụng kiến trúc lưu trữ phân tán kết hợp với Data Lake và Data Warehouse.
Thay vì lưu toàn bộ dữ liệu trên một máy chủ, Big Data được chia nhỏ thành nhiều phần và phân phối trên nhiều nút (node) trong cùng một cụm máy tính. Cách tiếp cận này giúp hệ thống mở rộng dễ dàng, tăng khả năng chịu lỗi và xử lý dữ liệu song song.
Vì sao Big Data cần mô hình lưu trữ khác với cơ sở dữ liệu truyền thống?
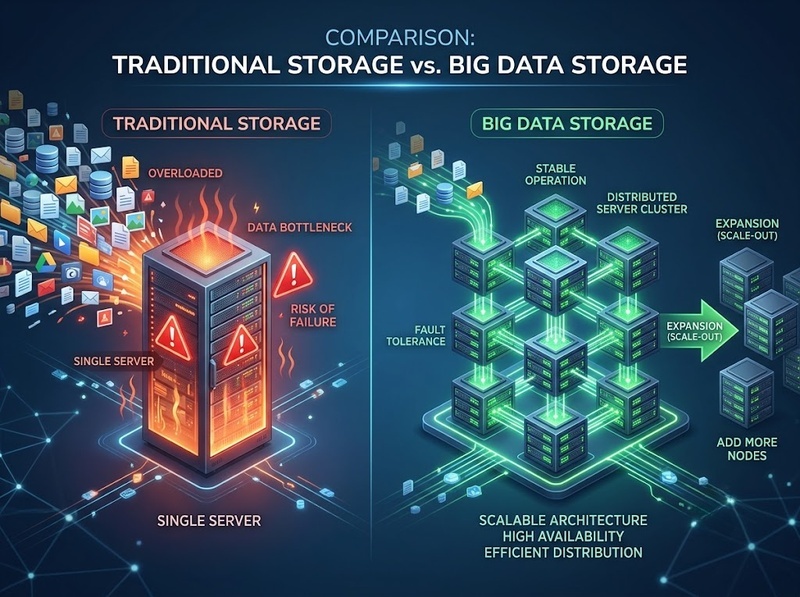
Cơ sở dữ liệu truyền thống thường được thiết kế để xử lý dữ liệu có cấu trúc với dung lượng vừa phải và được triển khai trên một hoặc một số ít máy chủ.
Trong khi đó, Big Data có những đặc điểm khác biệt:
· Dung lượng dữ liệu rất lớn (Volume)
· Dữ liệu phát sinh với tốc độ cao (Velocity)
· Bao gồm nhiều định dạng khác nhau (Variety)
· Yêu cầu khả năng mở rộng linh hoạt
· Cần duy trì tính sẵn sàng ngay cả khi một phần hệ thống gặp sự cố
Nếu chỉ sử dụng một máy chủ lưu trữ, chi phí sẽ tăng rất nhanh và hệ thống trở thành điểm lỗi duy nhất (Single Point of Failure). Vì vậy, mô hình lưu trữ phân tán trở thành nền tảng của hầu hết các hệ thống Big Data hiện đại.
Hệ thống lưu trữ phân tán hoạt động như thế nào?
Đây là mô hình cốt lõi trong lưu trữ Big Data.
Chia nhỏ dữ liệu
Một tập dữ liệu lớn sẽ được chia thành nhiều khối (block).
Ví dụ:
· File 1 TB có thể được chia thành hàng nghìn block
· Mỗi block được lưu trên các máy chủ khác nhau
Nhờ đó, nhiều máy có thể cùng đọc hoặc ghi dữ liệu đồng thời.
Sao chép dữ liệu
Để tránh mất dữ liệu khi phần cứng gặp sự cố, mỗi block thường được sao chép sang nhiều node khác nhau.
Nếu một node hỏng:
· Hệ thống tự động truy cập bản sao còn lại
· Người dùng hầu như không nhận thấy sự gián đoạn
Điều này tạo nên khả năng chịu lỗi (Fault Tolerance) – một đặc điểm quan trọng của hệ thống Big Data.
Mở rộng theo chiều ngang
Khi dung lượng tăng, doanh nghiệp không cần thay toàn bộ máy chủ bằng thiết bị mạnh hơn.
Thay vào đó chỉ cần bổ sung thêm các node mới vào cụm máy.
Việc mở rộng theo chiều ngang (Horizontal Scaling) giúp:
· Tăng dung lượng lưu trữ
· Tăng khả năng xử lý
· Giảm chi phí đầu tư so với các hệ thống tập trung
Data Lake lưu trữ Big Data như thế nào?
Data Lake là kho lưu trữ cho phép lưu dữ liệu gần như nguyên bản.
Nó có thể chứa:
· Dữ liệu có cấu trúc
· Dữ liệu bán cấu trúc
· Dữ liệu phi cấu trúc
Ví dụ:
· Hình ảnh
· Video
· Nhật ký hệ thống
· File PDF
· Dữ liệu IoT
· Log ứng dụng
· JSON
· XML
Đặc điểm của Data Lake
· Không bắt buộc chuẩn hóa dữ liệu trước khi lưu
· Có thể tiếp nhận dữ liệu từ nhiều nguồn
· Phù hợp với AI, Machine Learning và phân tích dữ liệu lớn
· Dễ dàng mở rộng dung lượng
Điểm mạnh lớn nhất là doanh nghiệp có thể lưu trữ dữ liệu trước, sau đó mới quyết định cách xử lý khi phát sinh nhu cầu phân tích.
Data Warehouse khác gì Data Lake?
Mặc dù đều lưu trữ dữ liệu, hai mô hình phục vụ các mục đích khác nhau.
Data Lake
· Lưu dữ liệu thô
· Hỗ trợ nhiều định dạng
· Phục vụ nghiên cứu và phân tích chuyên sâu
· Linh hoạt khi tiếp nhận dữ liệu mới
Data Warehouse
· Lưu dữ liệu đã được làm sạch
· Có cấu trúc rõ ràng
· Tối ưu cho báo cáo và phân tích kinh doanh
· Truy vấn nhanh, ổn định
Trong thực tế, nhiều doanh nghiệp triển khai cả hai:
1. Thu thập dữ liệu vào Data Lake.
2. Làm sạch, chuẩn hóa và tích hợp dữ liệu.
3. Chuyển dữ liệu cần thiết sang Data Warehouse để phục vụ báo cáo và phân tích.
Các thành phần thường xuất hiện trong kiến trúc lưu trữ Big Data
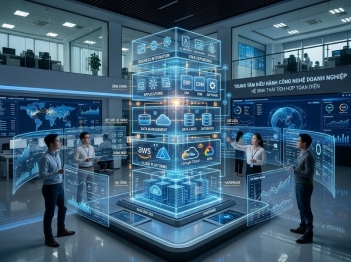
Một hệ thống Big Data hoàn chỉnh thường bao gồm:
Nguồn dữ liệu
· Website
· Ứng dụng di động
· ERP
· CRM
· IoT
· Mạng xã hội
· Thiết bị cảm biến
Lớp thu thập dữ liệu
Tiếp nhận dữ liệu theo thời gian thực hoặc theo lô.
Hệ thống lưu trữ phân tán
Lưu dữ liệu trên nhiều node nhằm đảm bảo:
· Khả năng mở rộng
· Khả năng chịu lỗi
· Hiệu năng cao
Data Lake
Lưu dữ liệu gốc phục vụ khai thác lâu dài.
Data Warehouse
Lưu dữ liệu đã xử lý để phục vụ báo cáo, dashboard và phân tích.
Công cụ phân tích
Các nền tảng BI, AI hoặc Machine Learning truy cập dữ liệu để tạo giá trị kinh doanh.
Ưu điểm của mô hình lưu trữ Big Data
Các mô hình hiện đại mang lại nhiều lợi ích:
· Dễ dàng mở rộng khi dữ liệu tăng
· Giảm rủi ro mất dữ liệu nhờ cơ chế sao chép
· Hỗ trợ xử lý song song trên nhiều máy
· Lưu trữ được nhiều loại dữ liệu khác nhau
· Phù hợp với phân tích dữ liệu thời gian thực
· Tối ưu chi phí khi triển khai trên hạ tầng phân tán hoặc nền tảng đám mây
Những thách thức khi lưu trữ Big Data
Bên cạnh ưu điểm, doanh nghiệp cũng cần lưu ý:
· Quản trị dữ liệu phức tạp
· Kiểm soát chất lượng dữ liệu
· Bảo mật và phân quyền truy cập
· Đồng bộ dữ liệu giữa nhiều hệ thống
· Tối ưu chi phí lưu trữ dài hạn
· Đảm bảo tuân thủ các quy định về bảo vệ dữ liệu
Một kiến trúc lưu trữ hiệu quả không chỉ phụ thuộc vào công nghệ mà còn cần quy trình quản trị dữ liệu rõ ràng.
Thay vì lưu dữ liệu trên một máy chủ duy nhất, Big Data sử dụng hệ thống lưu trữ phân tán để chia nhỏ và sao chép dữ liệu trên nhiều node nhằm tăng khả năng mở rộng và chịu lỗi. Data Lake đóng vai trò lưu trữ dữ liệu thô từ nhiều nguồn, còn Data Warehouse lưu trữ dữ liệu đã được xử lý để phục vụ phân tích và báo cáo. Việc kết hợp các mô hình này giúp doanh nghiệp xây dựng nền tảng dữ liệu linh hoạt, có khả năng đáp ứng nhu cầu phân tích và khai thác dữ liệu ở quy mô lớn trong dài hạn.
Hỏi đáp về lưu trữ Big Data
Big Data có phải luôn được lưu trên đám mây không?
Không. Big Data có thể được triển khai trên hạ tầng tại chỗ (on-premises), trên nền tảng đám mây hoặc theo mô hình kết hợp (hybrid), tùy nhu cầu và ngân sách của tổ chức.
Data Lake có thay thế Data Warehouse không?
Không hoàn toàn. Data Lake và Data Warehouse phục vụ các mục đích khác nhau và thường được triển khai song song để tận dụng ưu điểm của mỗi mô hình.
Vì sao lưu trữ phân tán quan trọng với Big Data?
Lưu trữ phân tán giúp tăng khả năng mở rộng, cải thiện hiệu năng xử lý và đảm bảo dữ liệu vẫn khả dụng khi một hoặc nhiều máy chủ gặp sự cố.
Big Data có chỉ lưu dữ liệu có cấu trúc không?
Không. Big Data có thể lưu trữ dữ liệu có cấu trúc, bán cấu trúc và phi cấu trúc như hình ảnh, video, tệp âm thanh, log hệ thống hoặc dữ liệu từ cảm biến.

GỬI Ý KIẾN BÌNH LUẬN
