
Hyperautomation được triển khai qua những công nghệ và bước nào?
Mục lục
Giải thích Hyperautomation là gì, các công nghệ cốt lõi và quy trình triển khai từ chọn quy trình, chuẩn hóa dữ liệu đến tích hợp AI, RPA, quản trị và đo lường.
Hyperautomation không phải là một phần mềm đơn lẻ và cũng không đơn thuần là đưa thêm AI vào RPA. Đây là cách tiếp cận có hệ thống để liên tục nhận diện quy trình có thể cải thiện, đánh giá cơ hội tự động hóa, lựa chọn công nghệ phù hợp, điều phối chúng thành luồng đầu-cuối rồi đo lường kết quả để tiếp tục tối ưu. Gartner mô tả hyperautomation như một cách tiếp cận có kỷ luật, định hướng bởi nhu cầu kinh doanh và sử dụng phối hợp nhiều công nghệ; IBM cũng nhấn mạnh sự kết hợp giữa AI, RPA và các công nghệ tự động hóa khác thay vì một công cụ duy nhất.
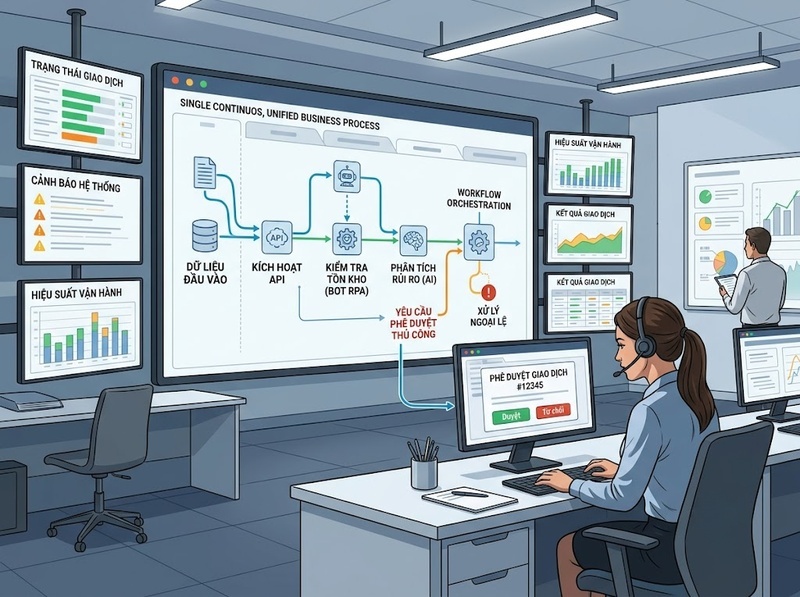
Vì vậy, mục tiêu thực tế không phải “tự động hóa mọi thứ bằng mọi giá”. Một quy trình có thể vẫn cần con người phê duyệt, giải quyết ngoại lệ hoặc chịu trách nhiệm cho quyết định có rủi ro cao. Giá trị của Hyperautomation nằm ở việc xác định phần nào nên tự động hóa, bằng công nghệ nào, dữ liệu đi qua đâu, khi nào cần chuyển cho con người và toàn bộ chuỗi đó được giám sát như thế nào.
Hyperautomation hoạt động theo cơ chế nào?
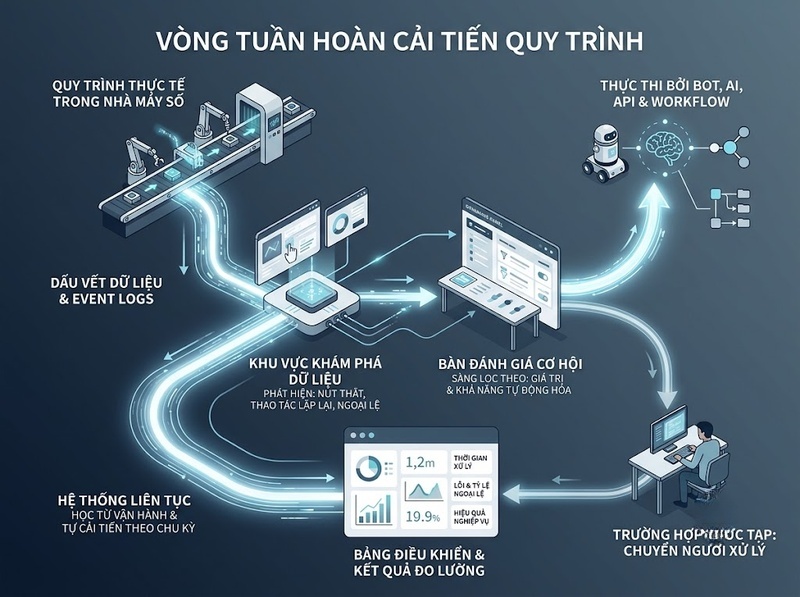
Một hệ thống Hyperautomation có thể được nhìn như một vòng lặp gồm bốn hoạt động liên tục: khám phá → đánh giá → tự động hóa → giám sát và cải tiến.
Ở giai đoạn khám phá, doanh nghiệp quan sát cách công việc thực sự diễn ra thay vì chỉ dựa trên quy trình được mô tả trong tài liệu. Dữ liệu giao dịch, event log, thao tác của người dùng và KPI vận hành giúp phát hiện các bước chờ, thao tác lặp lại, đường đi ngoại lệ hoặc những nơi nhân viên phải nhập dữ liệu thủ công.
Sau đó, các cơ hội được đánh giá theo giá trị kinh doanh và khả năng tự động hóa. Một thao tác lặp hàng chục nghìn lần nhưng thay đổi luật liên tục có thể không phải ứng viên tốt bằng một quy trình ổn định với khối lượng thấp hơn. Hyperautomation vì thế cần một bước vetting — sàng lọc và xác thực cơ hội trước khi xây bot hoặc mô hình AI.
Khi triển khai, nhiều loại công nghệ đảm nhiệm các chức năng khác nhau. RPA có thể thực hiện thao tác có quy tắc; AI xử lý tài liệu, ngôn ngữ hoặc dự đoán; workflow engine giữ trạng thái và điều phối công việc; API trao đổi dữ liệu giữa hệ thống; con người xử lý các trường hợp ngoài ngưỡng tự động.
Cuối cùng, kết quả được ghi nhận lại thành dữ liệu vận hành mới. Doanh nghiệp đo thời gian xử lý, tỷ lệ ngoại lệ, mức tự động hóa xuyên suốt, lỗi, chi phí và các KPI nghiệp vụ. Dữ liệu đó lại trở thành đầu vào cho vòng khám phá tiếp theo.
Đây cũng là điểm khác biệt giữa Hyperautomation và việc chỉ triển khai một bot RPA. IBM phân biệt intelligent automation — thường kết hợp RPA với AI/ML — với Hyperautomation ở phạm vi rộng hơn: Hyperautomation là cách tổ chức nhận diện, đánh giá và tự động hóa nhiều quy trình kinh doanh và CNTT một cách có hệ thống.
Những công nghệ nào tạo nên kiến trúc Hyperautomation?
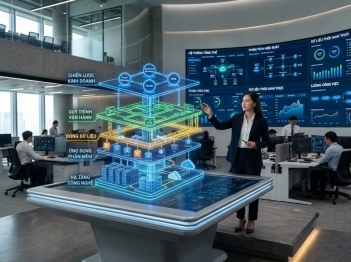
Không có một “stack Hyperautomation” duy nhất phù hợp với mọi doanh nghiệp. Tuy nhiên, một kiến trúc hoàn chỉnh thường cần các lớp phục vụ khám phá quy trình, thực thi, nhận thức, tích hợp và quản trị.
Process mining và task mining
Process mining giúp doanh nghiệp nhìn thấy quy trình dựa trên dấu vết số trong các hệ thống nghiệp vụ. Các nền tảng như ERP, CRM hoặc hệ thống dịch vụ thường ghi lại thời điểm và trạng thái của giao dịch. Dữ liệu này được chuyển thành event log để tái dựng đường đi thực tế của quy trình.
Trong mô hình phổ biến, một event log cần tối thiểu những thành phần như case ID, activity và timestamp. Từ đó có thể xác định biến thể quy trình, thời gian chờ, nút thắt và khu vực có tiềm năng tự động hóa. Microsoft cũng mô tả process mining như công nghệ khai thác dữ liệu sự kiện từ system of record để trực quan hóa quy trình, phân tích nguyên nhân kém hiệu quả và theo dõi KPI.
Task mining đi sâu hơn xuống cấp độ thao tác trên máy tính. Nó hữu ích khi một activity trong quy trình gồm nhiều bước nhỏ trải qua nhiều ứng dụng mà event log cấp hệ thống không phản ánh đầy đủ. Tuy nhiên, vì loại công nghệ này có thể thu thập dữ liệu thao tác người dùng, quyền riêng tư, phạm vi thu thập và kiểm soát truy cập phải được thiết kế ngay từ đầu.
Workflow, BPM và orchestration
RPA hoặc AI chỉ thực hiện từng phần công việc. Một lớp điều phối cần quyết định việc nào chạy trước, việc nào chạy sau, dữ liệu được chuyển cho thành phần nào, điều kiện nào tạo ngoại lệ và khi nào phải giao lại cho con người.
Workflow/BPM engine vì thế đóng vai trò như bộ điều khiển của quy trình. Nó có thể quản lý trạng thái giao dịch, SLA, rule nghiệp vụ, hàng đợi, phê duyệt và các nhánh xử lý khác nhau.
Trong Hyperautomation, orchestration đặc biệt quan trọng vì một transaction có thể đi qua API, AI, bot RPA và người phê duyệt trước khi hoàn tất. Nếu chỉ xây các automation riêng lẻ mà không có lớp điều phối, doanh nghiệp dễ tạo thêm một tập hợp “đảo tự động hóa” thay vì một quy trình đầu-cuối.
RPA
RPA phù hợp với những tác vụ số có logic rõ ràng và thường xuyên lặp lại: lấy dữ liệu từ màn hình, nhập thông tin vào hệ thống cũ, tải báo cáo, chuyển file hoặc thực hiện chuỗi thao tác theo rule.
IBM mô tả RPA thông qua các bot attended hoặc unattended có thể thực hiện tác vụ back-office lặp lại và được lập lịch hoặc điều phối. RPA cũng có thể được kết hợp với AI và process mining trong các sáng kiến Hyperautomation.
RPA không nên mặc định trở thành phương thức tích hợp cho mọi hệ thống. Khi một ứng dụng đã cung cấp API ổn định, kết nối ở lớp API thường giảm phụ thuộc vào vị trí nút bấm, selector hoặc giao diện màn hình. RPA hữu ích nhất khi phải làm việc với hệ thống legacy, ứng dụng desktop hoặc những điểm chưa có giao diện tích hợp thích hợp.
AI, machine learning và intelligent document processing
AI mở rộng phạm vi tự động hóa sang những bước mà rule truyền thống khó giải quyết, chẳng hạn:
· Phân loại email hoặc yêu cầu
· Trích xuất dữ liệu từ hóa đơn, hợp đồng và biểu mẫu
· Nhận dạng nội dung bằng OCR
· Phân tích ngôn ngữ tự nhiên
· Dự đoán khả năng xảy ra một sự kiện
· Hỗ trợ tạo hoặc tóm tắt nội dung bằng mô hình sinh
Điểm quan trọng là AI và RPA không làm cùng một việc. RPA thiên về thực thi; AI thiên về nhận biết, suy luận hoặc dự đoán. Một thiết kế tốt thường để AI tạo ra kết quả kèm confidence hoặc các tín hiệu kiểm tra, sau đó workflow quyết định có thể tiếp tục tự động hay cần con người xác nhận.
Dữ liệu, API và lớp tích hợp
Hyperautomation chỉ hoạt động ổn định khi các thành phần có thể trao đổi dữ liệu theo cách kiểm soát được. Lớp này có thể gồm API, integration platform, message queue, event bus, cơ sở dữ liệu, data warehouse và các connector tới system of record.
Dữ liệu đồng thời đóng hai vai trò: nhiên liệu cho automation và bằng chứng để đánh giá automation. Một quy trình có thể chạy được về mặt kỹ thuật nhưng vẫn không thể quản trị nếu doanh nghiệp không biết transaction nào đã đi qua bot nào, mô hình AI đã trả kết quả gì, ai phê duyệt ngoại lệ và trạng thái cuối cùng nằm ở đâu.
Bước 1: Chọn quy trình và xác lập đường cơ sở
Sai lầm dễ gặp là mua nền tảng trước rồi tìm xem có thể dùng nó ở đâu. Hyperautomation nên bắt đầu từ vấn đề vận hành và dữ liệu thực tế của quy trình.
IBM đặt việc thu thập insight về process, workflow và môi trường vận hành ở đầu hành trình Hyperautomation; process mining được dùng để tìm khoảng trống, độ trễ và bottleneck trước khi xác định cơ hội tự động hóa.
Một ứng viên tốt thường đồng thời có nhiều đặc điểm: khối lượng công việc đủ đáng kể, thao tác lặp lại, quy trình tương đối ổn định, dữ liệu đầu vào có thể tiếp cận, rule đủ rõ và giá trị cải thiện có thể đo được.
Ngược lại, cần thận trọng với những quy trình đang thay đổi liên tục, có quá nhiều ngoại lệ chưa được hiểu, phụ thuộc mạnh vào phán đoán chuyên gia hoặc có dữ liệu đầu vào quá kém. Tự động hóa một quy trình như vậy có thể làm lỗi chạy nhanh hơn thay vì loại bỏ lỗi.
Trước khi thiết kế solution, cần xác lập baseline. Tùy quy trình, bộ chỉ số ban đầu có thể gồm:
· Cycle time
· Touch time của nhân viên
· Số transaction trong một khoảng thời gian
· Tỷ lệ lỗi hoặc rework
· Tỷ lệ ngoại lệ
· Mức đáp ứng SLA
· Chi phí trên mỗi transaction
· Tỷ lệ hồ sơ cần xử lý thủ công
Baseline là điều kiện để sau này phân biệt giữa “automation đã chạy” và “automation đã tạo ra giá trị”. Đây là một điểm yếu đáng chú ý trong thực tế: Gartner năm 2024 cho biết dưới 20% tổ chức đã làm chủ việc đo lường các sáng kiến Hyperautomation.
Doanh nghiệp vì thế không nên dùng số lượng bot, số workflow hoặc số use case đã triển khai làm KPI chính. Các con số đó phản ánh mức hoạt động của chương trình, chưa chứng minh được tác động lên quy trình.
Bước 2: Chuẩn hóa dữ liệu và thiết kế tích hợp
Sau khi xác định quy trình cần xử lý, bước tiếp theo là vẽ lại luồng dữ liệu.
Với mỗi activity, cần biết dữ liệu đến từ đâu, ai sở hữu, được lưu tại hệ thống nào, đầu ra cần chuyển cho đâu và trạng thái nào được xem là nguồn sự thật. Nếu cùng một mã khách hàng được biểu diễn theo ba cách ở ba hệ thống, automation sẽ phải giải quyết bất nhất đó trước khi có thể hoạt động ổn định.
Một bản đồ dữ liệu thực dụng nên trả lời được:
· System of record của từng đối tượng nghiệp vụ là gì
· Dữ liệu nào có cấu trúc và dữ liệu nào không có cấu trúc
· Trường nào bắt buộc trước khi transaction được xử lý
· Thành phần nào được phép đọc hoặc ghi dữ liệu
· Transaction ID nào dùng để truy vết xuyên suốt
· Log và bằng chứng kiểm toán được lưu ở đâu
Đối với process mining, việc chuẩn hóa event data cũng rất quan trọng. Các nguồn như SAP, Salesforce hoặc các hệ thống nghiệp vụ khác có thể được trích xuất và chuyển thành event log trước khi tạo process graph và KPI. Kiến trúc process mining hiện đại thường gồm các lớp extraction, transformation, data storage và dashboard phân tích.
Sau dữ liệu là quyết định tích hợp. Một nguyên tắc kỹ thuật hữu ích là dùng API hoặc cơ chế tích hợp hệ thống khi chúng đáp ứng được yêu cầu; dùng RPA ở những điểm không có interface phù hợp.
Lý do nằm ở cơ chế phụ thuộc. API làm việc với hợp đồng dữ liệu và endpoint; bot giao diện phụ thuộc vào cửa sổ, selector, trạng thái màn hình hoặc luồng tương tác của ứng dụng. Khi UI thay đổi, automation dựa trên giao diện có thể cần sửa dù logic nghiệp vụ không đổi.
Hyperautomation không loại bỏ RPA vì lý do đó. Ngược lại, RPA chính là cầu nối quan trọng với legacy system. Nhưng nó nên được đặt đúng vị trí trong kiến trúc thay vì trở thành lớp tích hợp mặc định cho toàn bộ doanh nghiệp.
Bước 3: Kết hợp RPA, AI và điều phối thành luồng đầu-cuối
Khi dữ liệu và integration boundary đã rõ, doanh nghiệp có thể phân công nhiệm vụ cho từng loại automation.
Hãy lấy xử lý hóa đơn làm ví dụ. Một luồng Hyperautomation có thể hoạt động theo trình tự:
1. Hóa đơn đến qua email hoặc cổng tiếp nhận
2. OCR hoặc intelligent document processing nhận dạng nội dung
3. AI phân loại tài liệu và trích xuất các trường cần thiết
4. Workflow kiểm tra rule nghiệp vụ và mức confidence
5. API hoặc RPA tra cứu nhà cung cấp, đơn mua hàng và dữ liệu liên quan
6. Hồ sơ đủ điều kiện được ghi vào ERP; trường hợp bất thường được chuyển cho nhân viên
7. Kết quả xử lý được ghi log để theo dõi KPI và tiếp tục phân tích quy trình
Trong thiết kế này, không thành phần nào phải “thông minh” về toàn bộ quy trình.
AI chịu trách nhiệm ở nơi cần nhận dạng hoặc suy luận. RPA hoặc API thực thi hành động xác định. Workflow giữ trạng thái và điều phối. Con người tiếp nhận các ngoại lệ cần phán đoán. Dữ liệu vận hành kết nối các lớp với nhau.
IBM cũng mô tả một hành trình Hyperautomation trong đó tổ chức xác định dữ liệu đầu vào, lựa chọn platform và các công nghệ như RPA, OCR, AI và machine learning, sau đó kết hợp chúng để tự động hóa các quy trình phức tạp hơn.
Human-in-the-loop là một thành phần thiết kế
Mục tiêu của Hyperautomation không nhất thiết phải là 100% straight-through processing.
Với các tác vụ AI, doanh nghiệp có thể đặt ngưỡng confidence. Kết quả vượt ngưỡng và thỏa rule được tiếp tục tự động; kết quả không chắc chắn được đưa vào hàng đợi để con người xác minh.
Cách này đặc biệt quan trọng khi sai sót có hậu quả tài chính, pháp lý hoặc ảnh hưởng trực tiếp đến khách hàng. Nó cũng tạo dữ liệu phản hồi để đánh giá và cải thiện mô hình.
Human-in-the-loop vì thế không phải dấu hiệu cho thấy automation thất bại. Trong nhiều quy trình, đó chính là cơ chế giới hạn rủi ro và giữ trách nhiệm giải trình.
Xử lý ngoại lệ phải có ngay từ thiết kế
Một automation chạy đúng “happy path” trong demo chưa phải là một Hyperautomation có thể vận hành.
Cần xác định trước điều gì xảy ra khi API timeout, bot không tìm thấy control, dữ liệu thiếu trường bắt buộc, AI trả confidence thấp, một hệ thống downstream ngừng hoạt động hoặc transaction bị gửi trùng.
Mỗi tình huống cần có trạng thái, retry policy, cơ chế chống xử lý trùng, đường chuyển cho con người và log đủ để điều tra. Đây là khác biệt giữa một script tự động hóa và một quy trình có thể vận hành ở quy mô doanh nghiệp.
Bước 4: Kiểm thử, quản trị, đo lường và mở rộng
Hyperautomation cần được kiểm thử ở nhiều lớp hơn automation đơn lẻ. Ngoài việc kiểm tra bot có thực hiện đúng thao tác hay không, doanh nghiệp phải kiểm tra integration, dữ liệu, rule, ngoại lệ, quyền truy cập và chất lượng đầu ra của AI.
Với thành phần AI, các chỉ số phải phù hợp với nhiệm vụ. Một hệ thống trích xuất tài liệu có thể theo dõi accuracy theo từng trường; một mô hình phân loại cần quan sát false positive và false negative; một thành phần GenAI có thể cần schema validation, grounding, chính sách tool access và đánh giá chất lượng theo use case.
NIST AI Risk Management Framework tổ chức hoạt động quản trị rủi ro AI quanh bốn chức năng Govern, Map, Measure và Manage, đồng thời nhấn mạnh việc quản lý rủi ro xuyên suốt vòng đời AI. ISO/IEC 42001:2023 cung cấp một khung hệ thống quản lý dành cho tổ chức phát triển hoặc sử dụng AI, bao gồm quản trị rủi ro, khả năng truy vết và cải tiến liên tục. Đây là các tham chiếu hữu ích khi AI trở thành một mắt xích của Hyperautomation chứ không chỉ là thử nghiệm riêng lẻ.
Đo cả KPI kỹ thuật lẫn KPI kinh doanh
Một dashboard Hyperautomation nên có ít nhất hai tầng.
Tầng vận hành cho biết hệ thống có chạy ổn định hay không, với các chỉ số như:
· Automation success rate
· Exception rate
· Retry hoặc failure rate
· Tỷ lệ transaction cần con người can thiệp
· Thời gian xử lý của từng bước
· Chất lượng đầu ra của AI
· Tình trạng queue và SLA
Tầng kinh doanh đánh giá việc tự động hóa có giải quyết vấn đề ban đầu hay không, chẳng hạn:
· Cycle time trước và sau triển khai
· Cost per transaction
· Tỷ lệ rework
· Tỷ lệ xử lý straight-through
· Mức tuân thủ SLA
· Năng lực xử lý trong cùng nguồn lực
Hai tầng cần được nối với cùng một transaction ID hoặc mô hình dữ liệu tương thích. Nếu bot chạy nhanh hơn nhưng số hồ sơ phải sửa bằng tay tăng lên, chỉ số thời gian chạy bot sẽ tạo ra kết luận sai về hiệu quả.
Mở rộng bằng tài sản dùng lại, không bằng sao chép bot
Khi pilot thành công, bước tiếp theo không nên đơn giản là nhân bản automation sang hàng chục bộ phận.
Khả năng mở rộng tốt hơn đến từ các thành phần có thể dùng lại: connector, API, queue, component xác thực, module xử lý tài liệu, taxonomy ngoại lệ, template logging và rule governance.
Đồng thời cần xác định ownership. Process owner chịu trách nhiệm cho kết quả nghiệp vụ; IT hoặc platform team chịu trách nhiệm hạ tầng và integration; đội automation quản lý lifecycle; bộ phận chuyên môn kiểm soát rule; còn các thành phần AI cần thêm cơ chế quản lý dữ liệu, mô hình và rủi ro.
Mô hình quản trị này cũng giúp cân bằng một số trade-off khó tránh:
· RPA triển khai nhanh trên legacy system nhưng phụ thuộc nhiều hơn vào giao diện
· API cần đầu tư tích hợp nhưng thường tạo contract rõ ràng hơn giữa các hệ thống
· Low-code giúp phân quyền phát triển nhưng đòi hỏi guardrail để tránh automation phân tán
· AI mở rộng phạm vi xử lý nhưng tạo thêm yêu cầu về đánh giá, giám sát và ngoại lệ
· Straight-through processing cao giúp giảm thao tác thủ công nhưng không nên đạt được bằng cách bỏ qua những điểm kiểm soát cần thiết
Hyperautomation đạt độ trưởng thành khi doanh nghiệp có thể đưa một quy trình mới đi qua cùng một chu trình khám phá → đánh giá → thiết kế → triển khai → quan sát → cải tiến, thay vì xây mỗi automation như một dự án biệt lập.
Hyperautomation vì thế được triển khai hiệu quả nhất theo tư duy process-first và data-driven. Doanh nghiệp bắt đầu bằng việc hiểu quy trình thật, chọn đúng ứng viên và đo baseline; sau đó mới xác định phần nào dùng RPA, AI, workflow hay API. Các công nghệ này được kết nối thông qua dữ liệu và lớp orchestration, có human-in-the-loop cho ngoại lệ, rồi được giám sát bằng KPI vận hành lẫn KPI kinh doanh.
Khi cấu trúc đó được duy trì, Hyperautomation không còn là việc “cài thêm bot”. Nó trở thành một năng lực vận hành liên tục: phát hiện nơi công việc đang mất thời gian, lựa chọn cơ chế tự động hóa phù hợp, kiểm soát rủi ro và dùng dữ liệu thực tế để quyết định bước cải tiến tiếp theo.

GỬI Ý KIẾN BÌNH LUẬN
